把Transformer推理放到FPGA上,难点往往不是“能不能综合”,而是“怎么把高层次综合(HLS)写出来的C++内核,可靠地部署到云端FPGA卡上,并且知道错在哪一层”。2026年11月4日,David Rostcheck在arXiv发表的一篇论文(arXiv:2611.06829)给出了一条完整链路:从Vitis HLS C++到AWS EC2 F2实例上的Amazon FPGA Image(AFI),并用TinyBERT做地址命名实体识别,把嵌入层和第一个编码器层真正跑到了硬件上。
一、为什么盯上AWS F2
AWS F2实例自2024年12月上线,搭载AMD VU47P Virtex UltraScale+ FPGA:9,024个DSP、16GiB HBM、64GiB DDR4,按需计费,对研究项目比自购卡更友好。但论文指出,AWS 云 FPGA 服务面世八年(F1 自 2017 年、F2 自 2024 年 12 月),公开学术文献里几乎没有用它做 ML 推理的工作。障碍不是硬件,而是缺少一条可复现的“HLS C++→AFI”路径:AWS的HDK流程面向RTL,Vitis HLS不能直接生成AFI。
二、六段式工具链与四个桥接限制
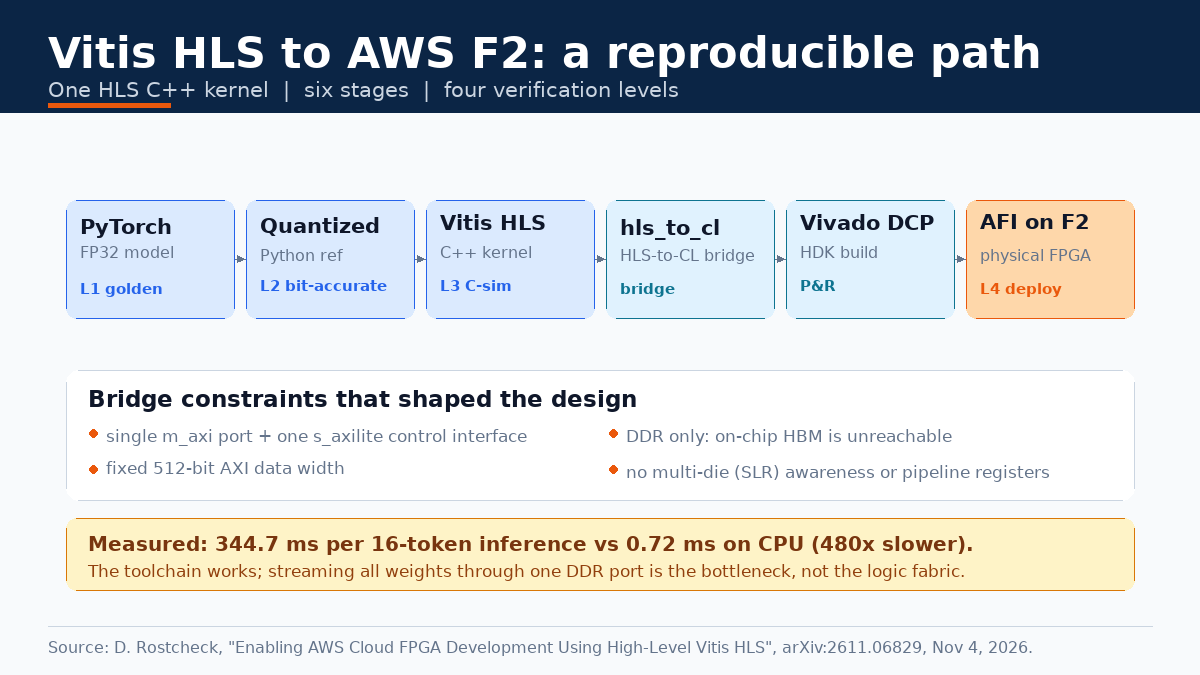
作者采用的流程是:Vitis HLS C++ → 导出RTL → 社区桥接脚本hls_to_cl.py → HDK Custom Logic工程 → 补丁 → Vivado DCP构建 → 生成AFI → 加载到F2。AWS的shell负责PCIe、DMA、DDR控制器等基础设施,用户的CL逻辑通过约定接口接入,两者最终一起综合成电路。
这条桥接路径并不完美,论文明确列出四个限制:每个内核只支持一个m_axi端口和一个s_axilite控制接口;只能连DDR,无法访问板上HBM;AXI数据宽度固定为512位;不感知多die(SSI)结构,不会自动插入跨SLR的流水寄存器。这四个限制后来直接决定了设计的性能上限——所有重量都要从主机DDR经单端口搬运,HBM的460GB/s带宽完全用不上。
三、模型、量化与存储布局
测试模型是TinyBERT:4层、隐藏维312、约1450万参数,任务是从地址文本中识别人名、街道、城市、州和邮编。作者选择W16A16(INT16权重×INT16激活),而不是更常见的INT8:INT8逐token量化在FFN阶段会产生最大86.0的中间误差,虽然对最终标签影响不大,但会让逐层对比无法区分“量化噪声”和“实现bug”;同时INT8的逐token除法会生成硬件除法器,WNS做到-1.148ns,无法满足250MHz。W16A16把除法换成float32倒数乘法,最大中间误差降到0.137,给调试留出了余量。
实现上,权重按通道absmax量化为INT16,激活按token absmax量化;INT16×INT16在ap_int48>中累加,四步反量化在ap_fixed64,32>中完成,遇到大累加值再临时加宽到ap_fixed80,48>,避免溢出。权重不常驻片上,而是从DDR按块流式读取——这消除了BRAM级联的时序违例,但也把延迟推高到由DDR带宽主导。
四、四级验证:把“错在哪”变成可定位的问题
论文最有复用价值的部分是四级验证:L1是FP32 PyTorch金标准;L2是用Python精确复现ap_fixed行为的位精确参考;L3是同一份HLS C++代码的C仿真;L4是物理FPGA上的AFI。每一级先与上一级对齐,再往下走。L2是关键:当L3/L4与L1不一致时,先看L1与L2的差异,判断是量化设计问题;再看L2与L3/L4的差异,判断是实现问题。
这套方法抓到了几个典型的HLS陷阱:hls::exp()在ap_fixed32,16>上经过布局布线后返回0,属于生成RTL的IP缺陷;hls::erf()会被提升为FP64,生成dmul_64/dadd_64,250MHz下无法收敛;64位定点除法生成sdiv_80ns_48ns_80,WNS为-1.148ns;桥接脚本没有把.dat初始化文件复制到综合目录,Vivado静默地把ROM填零,导致硬件上查找表对所有输入都返回0,而C仿真却完全正确。对应的修正分别是:2048项LUT实现softmax的exp、4096项LUT加线性插值实现GELU、用float32倒数乘法替代除法、以及在构建脚本中显式拷贝初始化文件。
五、三die时序收敛:21次以上DCP构建
VU47P由三个SLR(Super Logic Region)并排组成,跨SLR是长线,时序很难收敛。作者的嵌入层加编码器第0层构建中,BRAM成为瓶颈资源,占用36.1%的BRAM tile,而LUT仅5.6%、FF仅3.5%、DSP仅1.5%、URAM仅4.2%;BRAM在SLR0和SLR1之间几乎对半分(53.5%/46.9%),把注意力数据路径卡在边界上。最终把约60万元素的数组搬到URAM,才把WNS拉到+0.027ns。整个过程用了21次以上DCP构建:第一阶段从-1.533ns收敛到-0.050ns,第二阶段从-1.533ns收敛到+0.001ns;单次构建38至82分钟,开phys_opt再加11至41分钟。作者的经验是:默认Vivado指令比Performance_Explore快30%至50%,maxThreads=24能压满F2的24个vCPU,增量检查点能把小改动后的重建时间减少约40%。
六、结果:流程跑通了,性能却不好
精度方面,W16A16的F1为86.54,FP32基线为86.63,基本在噪声范围内;L3 C仿真与L2 Python的标签一致率为100%,说明HLS实现与位精确参考是对齐的。性能方面,在batch=1、序列长度16的设置下,FPGA完成嵌入层加编码器第0层需要344.7ms,CPU(c7i.xlarge,FP32)为0.72ms,GPU(g5.xlarge,A10G,FP32)为0.84ms——FPGA比CPU慢约480倍,比GPU慢约410倍。瓶颈不是逻辑资源,而是单端口DDR上反复搬运权重。
作者没有回避这个负结果:这套实现只是“工具链验证”,不是性能优化;要把FPGA的优势发挥出来,需要多通道DMA、HBM访问、片上权重缓存,或者选择更适合分布式存储的计算模式(例如传统ML、流式网络检测),而不是朴素地套用Transformer。
七、对工程团队的意义
这篇论文的价值不在“FPGA跑TinyBERT有多快”,而在把一条过去缺少文档的云端HLS部署路径写清楚,并给出了可复用的验证与收敛方法。对准备用云FPGA做原型验证的团队,至少有四点可以直接借鉴:第一,先建立位精确的L2参考,再谈上板;第二,把跨SLR的存储布局当作一等公民,BRAM/URAM放在哪里往往比逻辑优化更影响WNS;第三,对HLS数学库保持怀疑,exp、erf、除法这些“看起来没问题”的函数,必须在物理硬件上逐项验证;第四,先解决数据搬运,再谈并行度,否则算力只会被内存墙吃掉。
资料来源:D. Rostcheck, “Enabling AWS Cloud FPGA Development Using High-Level Vitis HLS”, arXiv:2611.06829, 2026-11-04, https://arxiv.org/abs/2611.06829;AWS F2实例与HDK文档。