全同态加密(FHE)被看作隐私计算的关键拼图:数据在密文状态下直接计算,云端不需要解密。但它的代价惊人——在基于CKKS的FHE深度学习推理中,数论变换(NTT)及其逆变换平均占用约63%的CPU时间。NTT把多项式乘法的复杂度从O(N²)降到O(N log N),是FHE性能的核心杠杆。2026年11月2日,巴塞罗那超级计算中心(BSC)与加泰罗尼亚理工大学的团队在arXiv发表论文(arXiv:2611.03325),把一颗端到端NTT/INTT内核做到了AMD Alveo V80的三块die上:400MHz、2^16点变换每5.12微秒一次,端到端卸载最高达到CPU的22倍。
一、为什么“只加速NTT”反而更难
已有FPGA工作大致分两类:一类加速完整FHE方案,速度快但绑定特定参数和算法;另一类只加速NTT,可跨方案、跨库复用,但多数设计采用迭代或部分展开结构,互连随并行度增长,在多die FPGA上布线困难。论文选择后者,并且把“端到端”作为目标:不仅要把内核做快,还要把它接进Lattigo库,让真实的密钥切换、自举和神经网络推理受益。
二、全展开、延迟交换器与流式接口
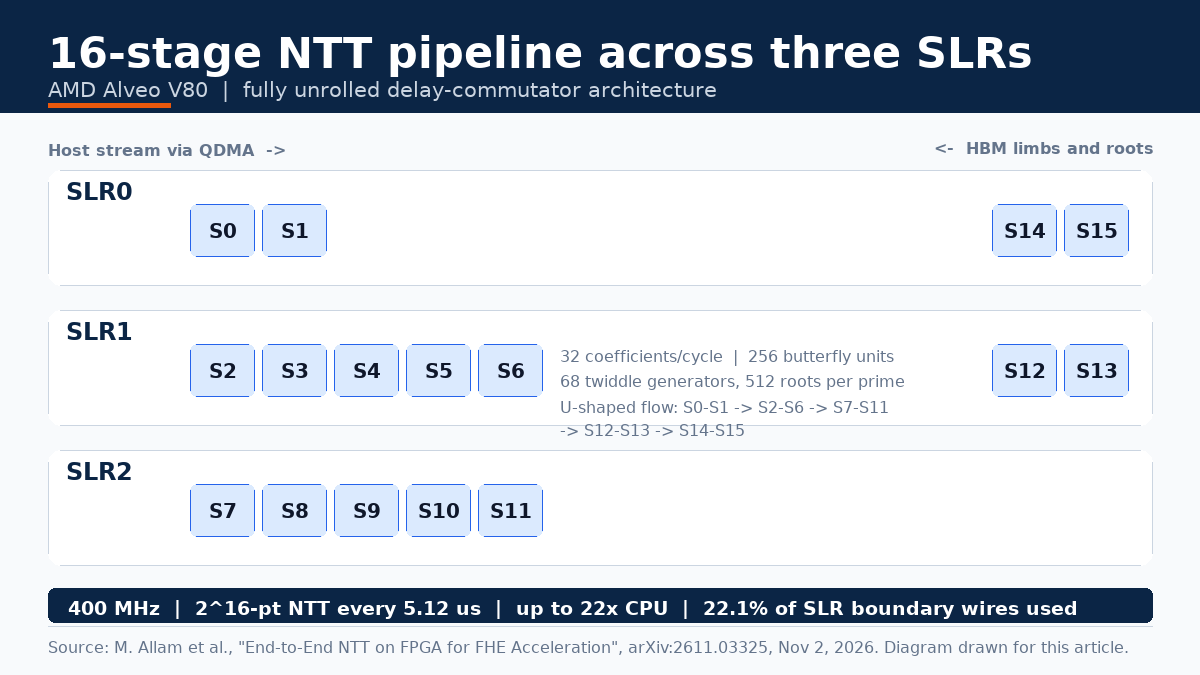
内核采用全展开的延迟交换器(delay commutator)结构:16级流水,每级16个蝶形单元,共256个蝶形单元;每个周期吞吐32个系数;系数重排不靠交叉网络或转置,而靠固定延迟和lane布线,降低了高并行度下的互连压力。旋转因子不是预先存进大表,而是由68个生成器根据每个模数的512个根实时产生,省下了片上存储和布线资源。
数据通路是流式的:主机通过QDMA的16个队列把limb送入卡,512位流接口进入重排缓冲(2个limb),再进入NTT/INTT流水线,输出经序列化器写回。控制面用AXI4-Lite寄存器,变换方向、模数、作业配置在流水线空闲时切换。这样的接口设计让内核可以按limb连续工作,而不是一次只能处理一个多项式。
三、三die floorplan:把“跨die”当成设计约束
Alveo V80有三个SLR,每个边界有18,870条super long line(SLL)。作者没有依赖工具自动布局,而是手工把整个内核映射到三个die:QDMA和流接口放在SLR0,HBM端口和旋转因子根存储放在SLR2;16级流水按U形分布——S0/S1和S14/S15在SLR0,S2至S6与S12/S13在SLR1,S7至S11在SLR2。每个SLR边界只允许两条级间数据字(每个方向一条,1,984位宽)和一条旋转因子广播穿过,并且两侧都打寄存器。最终每个边界只用了约4,178条SLL,占22.1%,没有布线拥塞。
400MHz的时序瓶颈不是逻辑深度,而是跨三个die的时钟域线延迟:关键路径平均只有4.65级逻辑,但74%的延迟来自布线。换句话说,这类设计的核心工作不是“写RTL”,而是“做物理规划”——把数据流、存储和时钟跨die的每一段都算清楚。
四、结果:5.12微秒一次变换,端到端22倍
内核在400MHz下闭合时序,使用V80约60%的DSP、约四分之一的LUT和FF;SLR1承载7级流水,DSP占用达到73.5%。对2^16个系数、62位素数,内核每5.12微秒完成一次NTT/INTT。把传输也算进去,单个limb的流式调用为89微秒(CPU的6.9倍);当33个limb流水起来后,平均每个limb降到28微秒,达到CPU的22倍,此时主机到卡的输入流占总时间的65%以上,双向各约18.8GB/s,接近21.3GB/s的接口峰值。
更有意义的是库级结果:内核集成进Lattigo v6.2后,在128位安全参数下,密钥切换(MulRelin)从154.1毫秒降到71.1毫秒(dnum=11,2.17倍);自举从12.04秒降到6.84秒(dnum=5,1.76倍);FHE神经网络推理整体加速1.81至2.08倍,单次推理中的NTT/INTT时间最多下降15.1倍。端到端加速比低于内核加速比,原因很直接:传输和FHE的其他算子仍然占时间,Amdahl定律在这里体现得很清楚。
五、工程启示与边界
这项工作给出了三个可复用的方法:第一,把NTT做成“可替换的内核”,而不是绑定某个FHE方案,才能跨库、跨参数复用;第二,多die FPGA上,手工floorplan和寄存器化跨die边界比单纯提高并行度更重要;第三,端到端集成和内核微基准要分开看,只有接进真实库、跑真实负载,才能知道收益在哪里被传输吃掉。
边界也很明确:它只卸载NTT/INTT,不改变FHE协议本身;主机到卡的流仍是主要瓶颈,作者提出的下一步是增加第二条流接口、利用V80的第二个PCIe控制器,或把内核并入更大的FHE加速器,让limb留在卡上。对做隐私计算硬件的人来说,这篇论文更像一张“工程路线图”:先解决数据搬运和跨die布局,再谈把更多算子搬上FPGA。
资料来源:M. Allam, T. Spendlhofer, H. Sanz-González, A. J. Peña, “End-to-End NTT on FPGA for FHE Acceleration”, arXiv:2611.03325, 2026-11-02, https://arxiv.org/abs/2611.03325;Lattigo v6.2.0 文档。