10月27日,“全球 AI 芯片 · 城市智能峰会” 在深圳落下帷幕,峰会全面聚焦城市视觉与城市算力领域,汇集了世界顶尖人工智能科学家、产业巨头首席技术高管、行业创业大牛,以及明星投资人共聚一堂,共同就 AI 产业发展的现状与趋势分享了各自的观点和最新的技术方案。本次会议共吸引了692位业内人参会,其中包含了64家企业的CEO、371名副总裁及总监级听众。
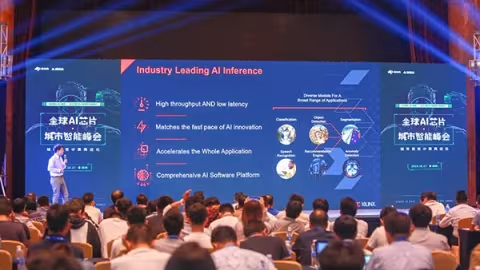
中国国际进口博览会由中华人民共和国商务部、上海市人民政府主办,旨在坚定支持贸易自由化和经济全球化、主动向世界开放市场。作为全球领先的半导体领导企业,业界首推自适应计算架构,FPGA/SoC/ACAP 的发明者,赛灵思公司(Xilinx)依然如约出席这一全球盛会,并一如既往地将最先进的技术带给大家。
ADC和DAC是FPGA与外部信号的接口,从数据接口类型的角度划分,有低速的串行接口和高速的并行接口。FPGA经常用来采集中高频信号,因此使用并行ADC和DAC居多。本文将介绍如何使用FPGA驱动并行ADC和并行DAC芯片。
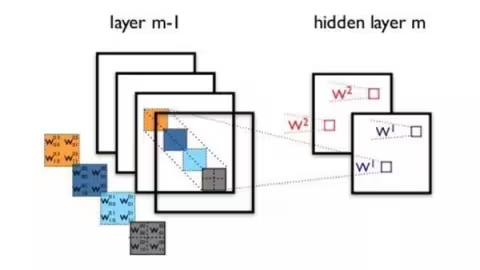
在上一篇介绍了如何将高维度卷积核拆分成低维度小卷积核,从而降低计算量的方法。本篇介绍的也是采用了降维的思想来加速网络推理,但是数学上采用了不同的方法。而且这篇文章提出的方法可以加速深度网络,其在vgg-16上进行了实验,获得了4倍的加速效果,而在imageNet分类中top-5错误率仅有0.3%升高。
Vitis™统一软件平台是一个集成开发环境(IDE),用于开发针对Xilinx®嵌入式处理器的嵌入式软件应用程序。Vitis软件平台可与通过Vivado®Design Suite创建的硬件设计一起使用。
本系列文章主要说明基于 Xilinx FPGA 的实时图像处理。虽然 FPGA 开发用的 HDL 语言与 Intel FPGA(前身 Altera)通用,但是比较开发工具软件差异的话,还是 Xilinx 开发效率更高。
迭代器是 23 种设计模式中最常用的一种(之一),在 Python 中随处可见它的身影,我们经常用到它,但是却不一定意识到它的存在。在关于迭代器的系列文章中,我至少提到了 23 种生成迭代器的方法。有些方法是专门用于生成迭代器的,还有一些方法则是为了解决别的问题而“暗中”使用到迭代器。
FPGA是实现高性能计算与网络的重要工具,得益于其高度的并行性与用户可编程的特性,FPGA得到了越来越广泛的应用。FPGA由CLB、BRAM、DSP48E1、可编程布线资源、可编程IO资源等部分组成,其中,CLB是实现逻辑功能的基础
荣登《财富》杂志“未来 50 强”榜单,不仅是对赛灵思持续引领自适应和智能计算发展战略方向的肯定,也是赛灵思从器件公司转型至平台公司取得重大进展的有力证明
通过一定的算法对事先选定的随机种子(seed)做一定的运算可以得到一组人工生成的周期序列,在这组序列中以相同的概率选取其中一个数字,该数字称作伪随机数,由于所选数字并不具有完全的随机性,但是从实用的角度而言,其随机程度已足够了。
设计中最快的时钟将确定 FPGA 必须能处理的时钟速率。最快时钟速率由设计中两个触发器之间一个信号的传输时间 P 来决定,如果 P 大于时钟周期 T,则当信号在一个触发器上改变后,在下一个逻辑级上将不会改变,直到两个时钟周期以后才改变。
一些UltraScale+™和Versal™设备提供了一个漂移温度,可以在有限的时间内将操作上限温度提高10°C。如果使用得当,这个特性可以扩展热解决方案的许多应用。
在CNN网络中卷积运算占据了最大的计算量,压缩卷积参数可以获得显著的硬件加速器的性能提升。在即将介绍的这篇论文中,作者就是通过张量的降维来降低卷积计算量的。作者通过CP分解将一个4D张量分解成多个低维度的张量,并且最后通过微调参数来提升网络精度。
任何学FPGA的人都跑不掉的一个问题就是进行静态时序分析。静态时序分析的公式,老实说很晦涩,而且总能看到不同的版本,内容又不那么一致,为了彻底解决这个问题,我研究了一天,终于找到了一种很简单的解读办法,可以看透它的本质,而且不需要再记复杂的公式了。
本篇将讨论MPSoC中IPI的应用。首先澄清这里的IPI不是小伙伴们熟知的Vivado IPI Design Flow的IPI(IP Integrator),而是Inter-Processor Interrupt,是MPSoC中用来在异构多核系统中以中断的形式实现小批量信息交互的结构单元。