前几天聊天聊到在Linux系统下调用SDK的gnu交叉编译工具链的问题,Panda同学是这么做的,简单写几句分享一下。按照正常套路,我们会专门下载第三方交叉编译工具链进行Xilinx器件的Linux开发
Verilog语言和VHDL语言是两种不同的硬件描述语言,但并非所有人都同时精通两种语言,所以在某些时候,需要把Verilog代码转换为VHDL代码。本文以通用的XHDL工具为例对Verilog转换到VHDL过程中存在的问题进行了总结
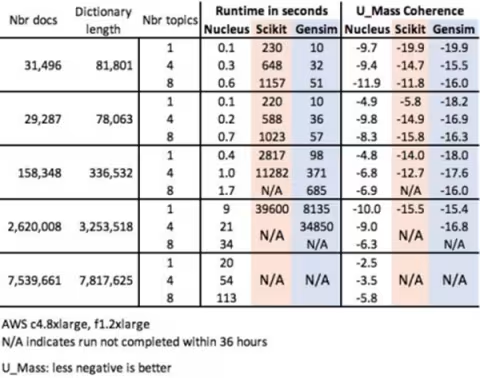
SumUp Analytics 的 Nucleus 平台是一个提供 Xilinx FPGA 支持的实时文本分析 SaaS 算法,用于从非结构化文本中识别、提取和分析重要信息。该平台在采用 Alveo™ U200 加速器卡的本地设备或 AWS EC2 F1 实例上无缝工作。Nucleus 不仅包括一个运行在 Xilinx FPGA 上的 Python/SDAccel 混合库,用于核心分析,而且还包括用于外设分析的分布式 CPU
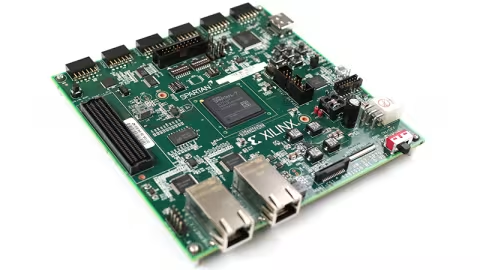
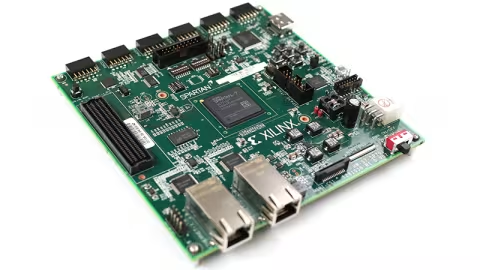
SP701 评估套件配备业界最佳性能功耗比 Spartan®-7 FPGA,适用于需要传感器融合的设计,如工业网络、嵌入式视觉和汽车等应用。SP701 通过 Pmods 和 FMC 连接器提供高 I/O 可用性和 I/O 扩展,使其成为 Spartan-7 FPGA 用户最大的 IP 开发平台。所包含的 XC7S100 FPGA 是 Spartan-7 系列中密度最大的器件。XC7S100 拥有 102K 逻辑单元和 400 个 I/O 引脚,可将可扩展连接与高处理能力进行配对,所有这些都通过统一封装提供,是边缘应用的理想选择。
使用 Xilinx 深度学习处理器(DPU)IP 构建自定义系统,使用面向 Xilinx SoC 的 DNNDK 优化经过训练的推断模型。
<iframe src='//players.brightcove.net/17209957001/SywTPUVC_default/index.html?videoId=6056721489001' allowfullscreen frameborder=0 width="600" height="400"></iframe>
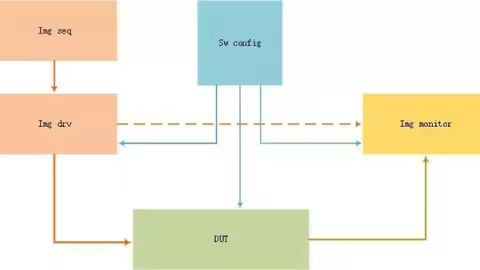
本篇完成对HDMI显示代码的UVM仿真,梳理一下在windows-modelsim工具下UVM仿真环境的建立,调试以及遇到的问题。仿真的架构在上一篇已经做了简要介绍,这部分做重点讲解
本文档描述了 Vivado 2019.1 中 PCI Express 内核的 UltraScale+ FPGA Gen3 集成块中集成的易用性特性。这些特性将在截图中详细介绍,以帮助用户更轻松理解其实现方案和用途。
文章阐述了Xilinx FPGA可编程的本质,逆向分析破解了FPGA编程的bit流文件,并将其与FPGA内部电路相对应,对于深度理解动态可编程及FPGA电路结构具有重要的指导价值,LUT动态可编程使得FPGA内部的资源使用起来更灵活,你可以把LUT当成BRAM使用,也可以随时改变若干个LUT组成电路完成的硬件功能
深度神经网络(deep nearal network)是机器学习发展20年来取得的最大突破,比如在语音识别方面,相比于传统方法,其将错误率降低了30%;而在2011年的图片识别竞赛上,将错误率从26%降低到3.5%,这些使得处于发展低谷的人工智能突然热门起来,从学术界扩展到工业界,甚至在google的alpha go击败了顶级围棋大师李世石后,人工智能成为全民讨论的热门,所有的程序员都梦想转行机器学习
自比特币诞生之后,PoW挖矿作为最主流的共识机制已经运行了十年有余,而近年来由于挖矿造成的巨大能源消耗、算力逐渐集中于几大矿池而趋向中心化,以及挖矿设备相对较高的准入门槛使得越来越多的人转向新的共识机制,如PoS、DPoS、PoC等等
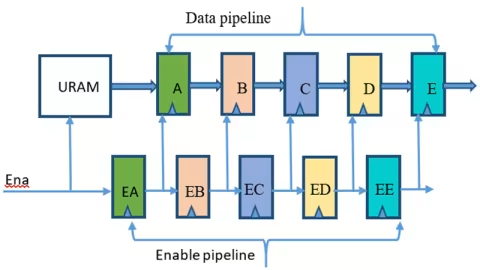
UltraRAM 原语(也称为 URAM)可在 Xilinx UltraScale +™ 架构中使用,而且可用来高效地实现大容量深存储器。URAM 原语具有实现高速内存访问所需的可配置流水线属性和专用级联连接。 流水线阶段和级联连接是使用原语上的属性来配置的。 本篇博文描述的是通过将 URAM 矩阵配置为使用流水线寄存器来实现最佳时序性能的方法。
使用逻辑回归、K 均值和交替最小二乘法加速您的 Apache Spark 应用。 AML 是 InAccel 的加速机器学习库。旨在维护其它开源框架(如 Apache Spark)简单易用的实用接口,同时加速机器学习模型的训练环节。现在 AML 拥有所有所需的库,可训练您的逻辑回归和 Kmeans 模型
Xilinx的FIR的COE文件应该是这样的:
fileID = fopen('fir_h.coe','w');
fprintf(fileID,'%s\n%s\n','radix=10;','coefdata=');
fprintf(fileID,'%.0f,\n',h);
fclose(fileID);
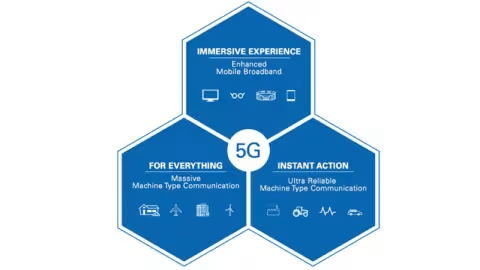
无线设备和其处理的数据量每年都呈指数递增(53% 复合年增长率。随着这些设备产生并处理的数据量越来越多,连接这些设备的无线通信基础设施也必须持续发展才能满足需求。如图 1 所示,4G 网络频谱效率的提高已经不足以提供 3GPP[2] 定义的三大高级 5G 用例所需数据速率的阶梯函数了
Verilog HDL (Hardware Description Language) 是一种硬件描述语言,可以在算法级、门级到开关级的多种抽象设计层次上对数字系统建模。它可以描述设计的行为特性、数据流特性、结构组成以及包含响应监控和设计验证方面的时延和波形产生机制
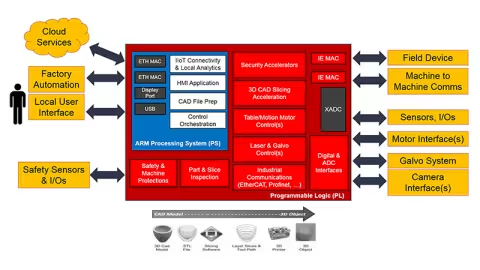
3D 打印领域正在材料与工艺、速度与复杂性,以及从制造商到大规模制造的商业模式等多个领域迅速发展。Xilinx SoC 和 FPGA 可为 3D 打印机设计人员和最终用户提供大量决定性优势
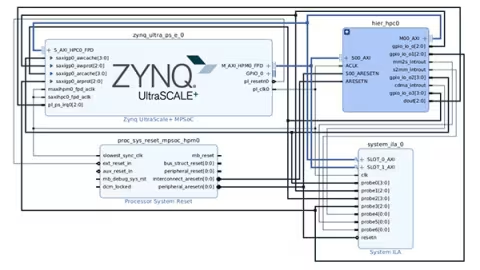
为了使相关传输被CCI监听,需要设置寄存器lpd_apu的最低两位为1,而且必须在A53处于复位态时设置。我们利用MPSoC BootROM在加载时设置寄存器lpd_apu。
为了用MPSoC BootROM在加载时设置寄存器lpd_apu,需要准备寄存器初始化文件,并且使用寄存器初始化文件创建启动文件boot.bin