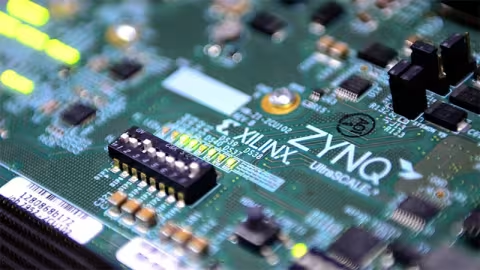
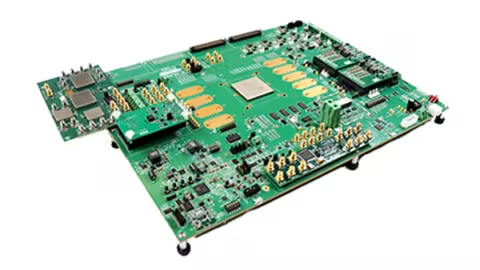
Zynq® UltraScale+™ RFSoC ZCU1275 特性描述套件提供您对集成型 ADC 和 DAC 以及 Zynq UltraScale+ XCZU29DR-2FFVF1760E RFSoC 上提供的 GTY 和 GTR 收发器进行特性描述和评估时所需的一切。
MPSoC是Xilinx基于16nm工艺推出的异构计算平台,由于灵活、稳定,在业界得到了广泛的使用。异构计算是一个比较新的领域,需要协调硬件设计、逻辑设计、软件设计,对工程师的要求很高。实际设计过程中,很多工程师对实现PS/PL之间的数据交互感到头疼。本文将介绍主要的PS/PL之间的数据交互办法。
安全套接字层 (SSL) 或传输层安全 (TLS) 在 Xilinx® Alveo™ 卡上提供完整的 TCP 卸载引擎 (ToE), 是提高系统级性能的理想选择,因为它提供 TCP 和加密工作的完全卸载。
PYNQ作为一套开源框架,其一大优势是软件框架的兼容性,正如PPT中介绍的,基于PYNQ框架,我们不仅可以接入常用的Numpy, Pandas等,也可以接入机器人操作系统ROS。
glitch:毛刺,glitch-free clock switching circuit:无毛刺时钟切换电路,今天讨论的主题就是如何实现时钟的无毛刺切换,本文将从有毛刺的时钟切换电路、无毛刺的源同步时钟切换电路、无毛刺的异步时钟切换电路三方面展开
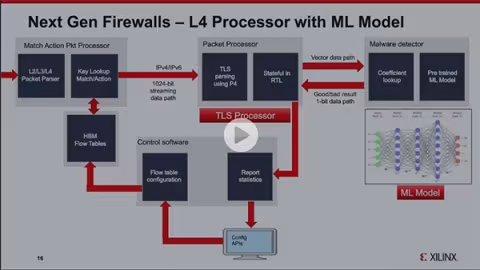
随着基于云的网络的增加,大量数据流入和流出企业网络,企业网络中的流量也呈指数增长。下一代防火墙安全设备需要具有高处理能力的高级安全方案和威胁防御措施,以及恶意软件检测功能。
UBoot作为boot loader,默认留给malloc分配的内存的大小有限。这个大小由宏TOTAL_MALLOC_LEN定义。它在include\Common.h文件里,从宏CONFIG_SYS_MALLOC_LEN派生出来
您是否想创建自己带有 AXI4-Lite 接口的 IP 却感觉无从着手?本文将为您讲解有关如何在 Vitis HLS 中使用 C 语言代码创建 AXI4-Lite 接口的基础知识。
AXI4协议基于猝发式传输机制。在地址通道上,每个交易有地址和控制信息,这些信息描述了需要传输的数据性质。主从设备间的数据传输有两种情况,一种是主设备经过写通道向从设备写数据(简称写交易),另一种是主设备经过读通道从从设备那里读取数据(简称读交易)
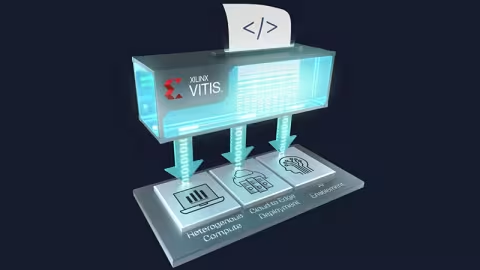
为了让大家更好的了解Vitis™ / Vitis™ AI统一软件平台和如何使用Vitis™ / Vitis™ AI进行此次比赛设计。本次加速教程邀请到 Adam Taylor 一起了解如何使用Vitis™ 和Vitis™AI 启动设计
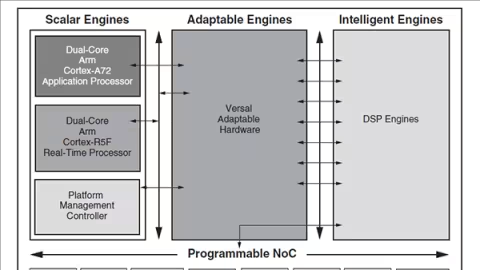
AI 无处不在、随时在线和以数据为中心的时代,正催升对更高带宽的需求,而这已经超出了当今技术和产品尺寸的能力范畴,世界需要一种当前 CPU 和 GPU 技术所无法企及的更高效、更普及、普适的计算,自适应计算应运而生。
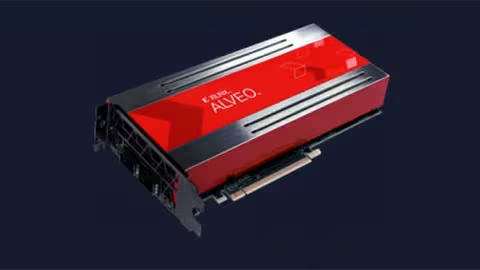
地震层析成像技术广泛用于油气勘探。全波形反演已经适用于今天的大型地震数据集。3D 反演仍然是一项重大的计算挑战,大型异构高性能计算 (HPC) 系统的出现带来了将全波形反演转化为一种广泛使用的常规方法的可能。DeePoly 利用 Xilinx Alveo 卡加速 FWI 算法,与 GPU 解决方案相比提高了 50%。
Hot Chips,全球高性能芯片领域最负盛名的业界盛会!虽受疫情影响,本届 Hot Chips 会议报告质量依然非常之高,涵盖范围也非常之广。在 Tutorial 部分,有来自于 Google TPU 团队、Cerebras、百度的机器学习训练专题,也有来自于 Google、IBM 等的量子计算专题。本文将主要讨论和机器学习相关部分的产品与趋势。
9月10日 19:30,赛灵思数据中心业务拓展经理梁晓明,以及专注于视频数据应用创新的科技公司 Aupera (傲睿智存科技 )CTO 周正宁,将联手揭秘 Xilinx Alveo U30 的价值与优势,共同分析视频转码的难点与瓶颈,并结合实例详细解析如何通过视频转码与 AI 的深度融合,满足视频服务市场日益增长的性能及多元化服务需求
结合机器学习和深度学习实现的 CTR 预估模型,相较于传统机器学习,模型评估指标大幅度提升。通过 FPGA 实现模型的推断过程,大幅度提高吞吐量,降低时延,对互联网公司大规模部署推荐系统节省更多成本。适用于广告 CTR 预估、推荐系统、新零售等场景。 相较于 96vCPU 服务器,雪湖的 FPGA 加速器把吞吐量提高了 2.4 倍,时延降低了 5.7 倍
建议的上电顺序为VCCPINT,然后是VCCPAUX和VCCPLL,然后PS VCCO提供(VCCO_MIO0,VCCO_MIO1和VCCO_DDR)以实现最小电流消耗并确保I / O上电时为3态。在上电序列中,要求将PS_POR_B输入置为GND。直到VCCPINT,VCCPAUX和VCCO_MIO0达到最低操作级别,才能确保PS eFUSE完整性
本次网络研讨会描述了两个使用 Zynq UltraScale + RFSoC 进行无线通信的设计示例。 首先,让我们回顾一下针对大规模 MIMO(64x64),100MHz LTE(ORAN 7.2 split)的设计,并解释其实现和选型性能数据。