在本视频中,赛灵思向世界隆重推出了 Xilinx 统一软件平台。该平台不仅仅是一个编译器,而是一个面向 Xilinx 器件的所有软件开发的集成开发环境 - 从 AI 引擎到嵌入式系统,再到数据中心的高性能算法加速。
因为ZYNQ 的PS 和PL 部分的电源有上电顺序的要求,在电路设计中,按照ZYQN 的电源要求设计,上电依次为1.0V -> 1.8V -> 1.5 V -> 3.3V -> VCCIO
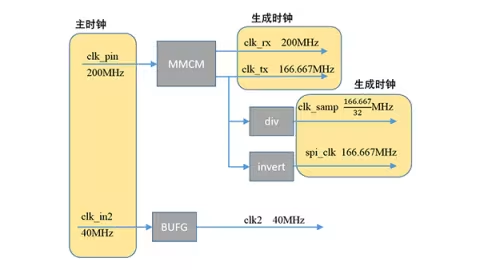
Vivado会自动设别出两个主时钟,其中clk_pin_p是200MHz,这个是直接输入到了MMCM中,因此会自动约束;另一个输入时钟clk_in2没有约束,需要我们手动进行约束。
在Versal架构中可用于编程,测试和部署AI引擎加速的应用程序的工具概述。除了基本的编程模型外,我们还将研究仿真和验证流程以及将AI引擎集成到您的总体设计架构中。
我们以Vivado自带的wave_gen工程为例,该工程的各个模块功能较为明确,如下图所示。为了引入异步时钟域,我们在此程序上由增加了另一个时钟--clkin2,该时钟产生脉冲信号pulse,samp_gen中在pulse为高时才产生信号。
本演讲视频将介绍从云到边缘的 Xilinx 全新统一 AI 平台。视频将涵盖通过剪枝器、量化器、编译器和运行时的基本工具流程,以直接从TensorFlow 等框架实现 AI 推断。
Xilinx的针对Gigabit应用的FPGA基本都会集成一些高速串行接口,统称为Gigabit Transceiver(GTx),包括GTP、GTR、GTX、GTH、GTZ、GTY(传输速率不断增加)等,不同系列的FPGA集成的GTx不同。
For 循环是解决问题的瑞士军刀,但是,当需要浏览代码以快速阅读你所做的事情时,它们可能会让人不知所措。有三种技术 — map、filter 和 reduce — 可以通过描述如何进行迭代来代替 for 训练。JavaScript 中也有这些技术,但是在 Python 中的实现略有不同。
所有市场的安全性都变得越来越重要。 在Zynq®UltraScale +™平台上使用受信任的执行环境(TEE),通过将安全关键元素与系统的其余部分隔离开来,可以提供主要的安全优势。
在xdc文件中,按约束的先后顺序依次被执行,因此,针对同一个时钟的不同约束,只有最后一条约束生效。虽然执行顺序是从前到后,但优先级却不同;就像四则运算一样,+-x÷都是按照从左到右的顺序执行,但x÷的优先级比+-要高。
在本视频中,您将了解使用 Versal ACAP 器件进行 AI 推断的优势,以及如何将神经网络模型映射至异构架构 - 包括 AI 引擎、自适应引擎和标量引擎。课程还将介绍支持直接从 TensorFlow 等行业标准框架进行 AI 模型推断的软件堆栈。
“算力”在未来,就像当年的蒸汽机、电力一样,俨然已经是生产力发展的核心要素,也就是说,谁拥有超越别人的“算力”,谁就会拥有更高的生产力和效率,谁也就能在创新上实现真正的突破,成为推动产业和时代进步的原动力。所以“算力”会和“原力”一样成为人们期望拥有的能力。
12月4日,伴随最后一场动手实验室的结束,2019 赛灵思开发者大会(XDF)在北京正式落下帷幕。通过两个多月的时间,赛灵思致力于将强大的自适应技术带给现场和没能到场的所有开发者,无论是软件工程师,还是AI科学家。- 自即日起,请关注赛灵思官微, 及时获取各种内容的下载及解读。
在上一篇文章中,我们简要介绍了更高层次的问题,这些问题为优化加速器的需求奠定了基础。作为一个尖锐的问题提醒,现在让我们通过一个非常简单的图像分类算法,来看一看与之相关联的计算成本与功耗。