技术

流语义寄存器:轻量级RISC-V扩展,单发射核计算利用率挂满!

先进处理器(CPU、GPU等)遭遇利用率墙时,开发重心从制造工艺转向工艺感知型计算机架构,聚焦能效。

YunSDR小课堂-帧同步与信道编码(第86讲)

既然我们能够成功地跨无线链路恢复数据,接下来可以讨论使该过程更具鲁棒性的技术手段。信道编码是显而易见的方案,且在所有数字通信标准中均普遍采用。

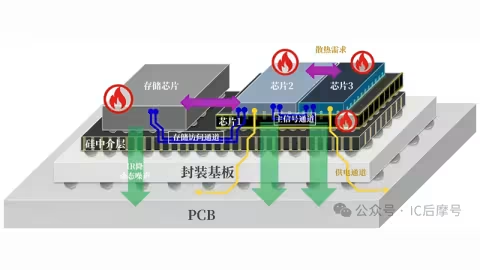
基于DNN芯粒的存内计算架构仿真

由于深度学习(DL)模型规模的不断增长,在大型单片芯片上实现用于深度学习的存内计算(IMC)面临面积、良率和制造成本方面的挑战。

双端口 RAM 必踩坑:地址冲突与三种写模式全解

在本博客中,我们将探讨简单双端口 RAM 模块中地址冲突的概念,并深入研究各种写模式及其对地址冲突的影响。

如果你还在为超宽带信号的处理延迟头疼,这篇文章值得你花3分钟!

当数据速率高到让传统FPGA都束手无策,该怎么办?如果你正在从事雷达、电子战、频谱监测,或是5G/6G卫星通信的前沿开发,你一定知道这样一个事实

从PetaLinux到EDF迁移开发指南

 AMD嵌入式开发框架(EDF)是一个完整的开源环境,旨在帮助嵌入式工程师基于AMD自适应SoC高效评估、开发和部署应用。

面向AI的芯粒组合

本文的设计范例,由一个CPU和两个机器学习加速器组成,采用仿真的芯粒配置,并使用高级接口总线(AIB)进行连接。

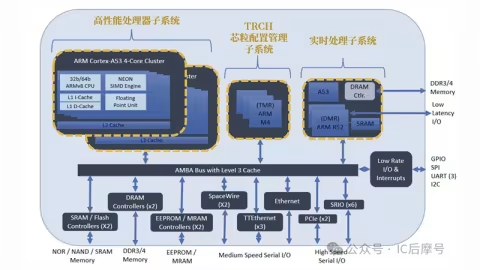
高性能空间处理器芯粒架构与性能测试

由美国空军研究实验室(AFRL)和美国国家航空航天局(NASA)赞助的一款高性能航天计算(HPSC)处理器,基于芯粒的架构由波音公司为太空任务开发。

Versal AIE实现高性能波束赋形算法

AIE以其卓越的计算密度、能效比和灵活性,成为实现5G及未来6G波束成形的理想平台,为无线通信的发展提供了强大的算力支持。

可扩展DNN加速器:多芯粒推理架构

在一项坦福、麻省理工和英伟达的多芯片模块研究中,通过地参考信号生成以网格网络连接的36个芯粒组成的深度神经网络加速器,其架构显示出灵活扩展性

突破 PMU 测量瓶颈:精密 ADC 实现模拟输出精准采集

自动化测试设备 (ATE) 机架包含各种电子子系统,可用于进行半导体测试。VI 卡的功能是提供精确稳定的电压和电流源以及测量来测试半导体器件的电气特性
PCIe降速桥的原理及特点

降速桥种类较多,如PCIe降速桥、以太网降速桥、MIPI降速桥等。本文主要介绍亚科鸿禹PCIe Gen5降速桥的原理及特点。

AMD Vivado™ 2024.1 中 “AMD Versal™ CPM5 QDMA Gen4x8 ST Only Performance Design” CED 示例
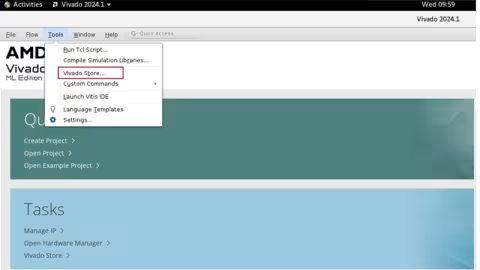
一文看懂 AMD Vivado™ 2024.1 中 “AMD Versal™ CPM5 QDMA Gen4x8 ST Only Performance Design” CED 示例。
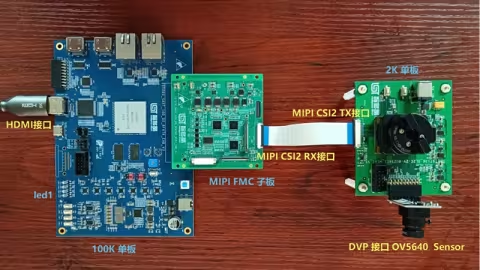
从摄像头到显示器:DVP转MIPI CSI-2视频传输方案深度拆解

本文将聚焦CPLD在DVP转MIPI过程中的核心作用,拆解其内部模块设计与实现思路。

YunSDR小课堂-帧同步与信道编码(第84讲)

在前几章中,我们已经讨论了频率校正、时序补偿以及匹配滤波。同步的最后一个方面是帧同步。

在 Versal Gen2上通过 JTAG 启动 EDF镜像并刷写 UFS 的流程
本文基于 EDF 2025.11 版本进行测试,记录了在 VEK385 开发板上,如何:通过 JTAG 模式 启动 EDF 镜像;使用 TFTP 引导 Linux 内核与 rootfs;


在 ZCU102 上使用 PS AXI性能监视器(APM)测量 PS内部的DDR 带宽
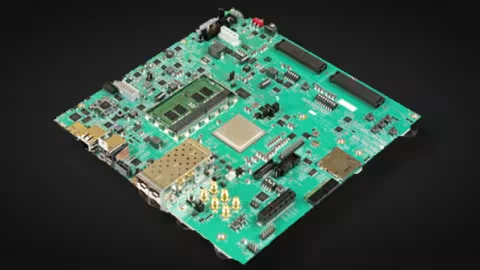
本文提出了一种基于 PS的AXI 性能监视器(APM)在 ZCU102 开发板上实现的硬件级 PS内部DDR 带宽监控解决方案。

FPGA仿真环境搭建与使用技巧(I)
今天这篇文章,就给大家把Vivado+ModelSim/QuestaSim仿真环境的全流程讲透,从软件下载、版本选择,到库编译、环境配置,再到 Windows系统卡死的专属解决方案
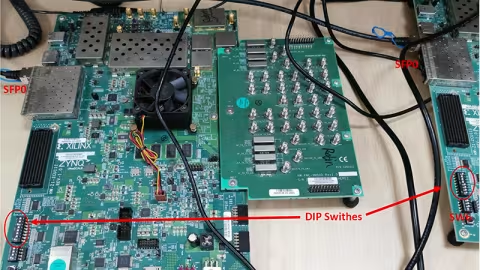
ORAN wireless-xorif 硬件演示

本篇博文会为您演示如何生成设计,以及在评估板启动后如何使用 API 来配置 CC 设置。

FPGA组合逻辑设计技巧分享4

使用关系运算符时,应尽可能保证两个操作数的位宽相等,或者使用unsigned或signed数据类型。