本文是关于Hot Chips 31大会观察与思考的系列文章的第二部分。整个系列将介绍我在Hot Chips大会上的几点观察与思考,涵盖以下几点内容:
要在设计中精确建模外部时序,必须为输入和输出端口提供时序信息。Xilinx Vivado集成设计环境(IDE)仅在FPGA边界内识别时序,因此必须使用以下命令指定超出这些边界的延迟值
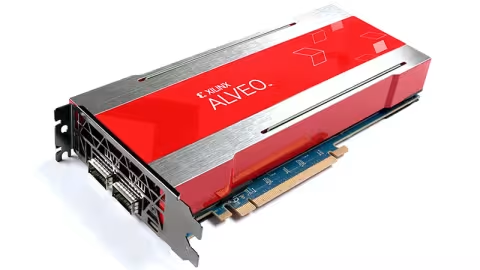
本文详细介绍了 Alveo™ U280 数据中心加速卡,它是采用了 Xilinx® Virtex® UltraScale+™ 技术的标准 PCIe® (Peripheral Component Interconnect express) Gen3 x16 加速卡。
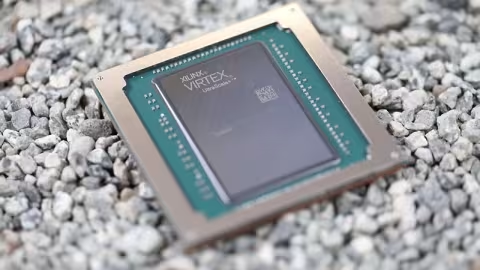
Xilinx 推出全球容量最大的 FPGA - Virtex® UltraScale+™ VU19P,不仅能实现当今最先进 ASIC 和 SoC 技术的原型与模拟设计,还能支持各种复杂的新兴算法。
前面我们已经学习了TCP的所有发送、接收和各种回调函数。本文将介绍最后一部分,TCP的轮询机制。在前面TCP发送Hello World的实例中,我们是在main函数的while循环中每隔1s调用一次数据发送函数。本文的实例将利用轮询机制完成同样的功能。
今天是OpenPOWER基金会历史上最重要的日子之一。伴随着IBM宣布对开源社区的新贡献,包括开源POWER指令集架构(ISA)与在2019 OpenPOWER北美峰会上公布的关键硬件参考设计,POWER架构的未来从未如此光明。
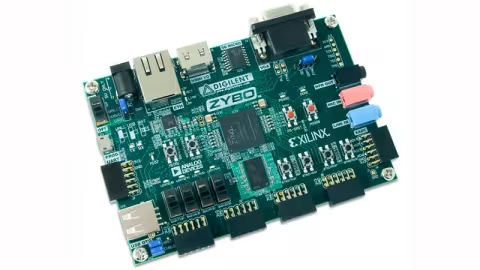
ZYNQ内部的总体框架如所示,PS中包含2个ARM Cortex-9的内核,一些基本的外设扩展口以及Memory接口。PS和PL的相互通信通过两个通路完成,分别是GP(General Purpose)Ports和HP(High Performance)Ports。GP Ports包含2个Master接口和2个Slave接口,符合标准的AXI协议数据位宽是32bit。HP Ports包含4个接口,全部是PL作为Master
2019年8月19日到21日,第31届Hot Chips大会在斯坦福大学成功举办。 本次大会确实是有非常多非常扎实的工作,也展现了整个处理器与高性能芯片领域行业的趋势与变化。本系列文章将介绍我在Hot Chips大会上的几点观察与思考,涵盖以下几点内容:
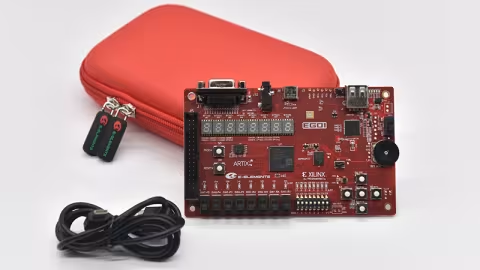
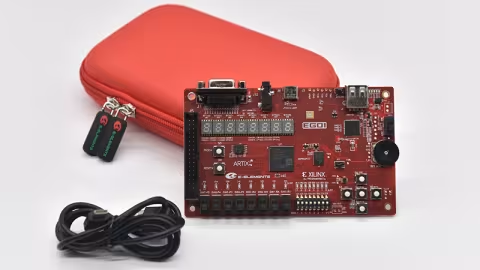
软件:Vivado2017.4 板卡:Ego1 型号:xc7a35tcsg324-1。打开Vivado,创建一个名为design_test的空白工程。点击Add source或者Sources中的+号来添加或者创建一个设计源文件,点击Next。
在数字设计中,时钟代表从寄存器(register)到寄存器可靠传输数据的时间基准。Xilinx Vivado集成设计环境(IDE)时序引擎使用ClocK特征计算时序路径要求,并通过松弛计算报告设计时序裕度(Slack)。
本次研讨会将为所有医疗设备的架构师和设计人员介绍一种可适用于所有工业自动化,以及其他高可靠性应用的功能安全策略和网络安全方法,同时还将介绍赛灵思的方案是如何应用于基于风险管理的意料设备设计流程中的,从而帮助客户创建更稳健的设计,加快上市时间
PS模块通过axi_bram模块,可以使用AXI接口读写PL内的Block RAM,实现PS与PL之间的数据互联。axi_bram需要与Block Memory Generator模块共同使用,axi_bram将PS的AXI操作转化为bram的控制接口时序。建立Vivado工程,并且添加Zynq模块,AXI BRAM Controller模块,Block Memory Generator模块,Utility Vector Logic模块和ILA模块。
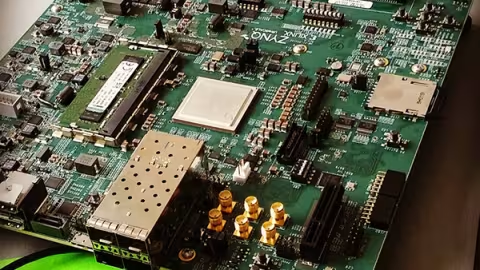
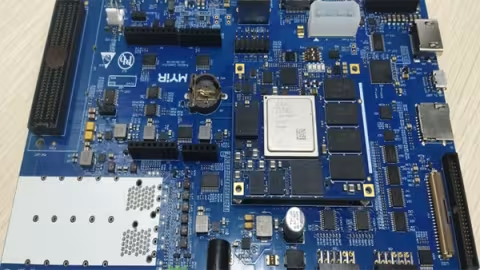
米尔科技推出的MYD-CZU3EG开发套件搭载的就是UltraScale+ MPSoC平台器件 — XCZU3EG,它集成了四核Cortex™-A53 处理器,双核 Cortex™-R5 实时处理单元以及Mali-400 MP2 图形处理单元及 16nm FinFET+ 可编程逻辑相结合的异构处理系统,具有高性能,低功耗,高扩展等特性,除了这款异构SOC之外,板子还搭载了丰富的接口和完善的开发资料
经常听到有媒体问ASIC是否取代FPGA这类问题,看看ASIC设计流程,其中的数字前端中的仿真和验证是离不开FPGA的,所以FPGA和ASIC是共生关系,有了更大的FPGA ,才能在数字IC仿真原型设计效率上大大提升,才可以支持和设计更复杂更大的ASIC,近10年来,赛灵思一直保持着最大业内FPGA的记录,今天,赛灵思再次刷新最大FPGA的新记录
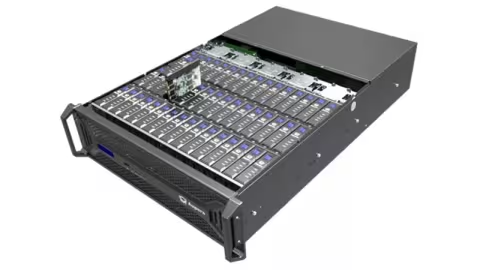
Aupera Technologies 是数据中心视频处理系统领域的新兴企业。Aup2600 是一种专用分布式视频处理系统,内置 48 个赛灵思 Zynq® UltraScale+™ MPSoC。此外,Aup2600 还提供基于赛灵思 Vivado 环境的完整视频 +AI 软件框架和用于神经网络处理的深度学习处理器单元 (DPU)。