在 2019 年 8 月 22 - 23日,2019全球闪存峰会上,赛灵思作为 FPGA 的发明者将现场展示我们的 “基于 FPGA 的 NVMe Target 控制器” 解决方案。同期在闪存存储网络论坛上,赛灵思公司数据中心架构师,唐杰也将做《FPGA 助力计算和存储的结合》的主题演讲,与参会者共同探讨新的大数据时代,计算和存储所面临的新挑战和新趋势
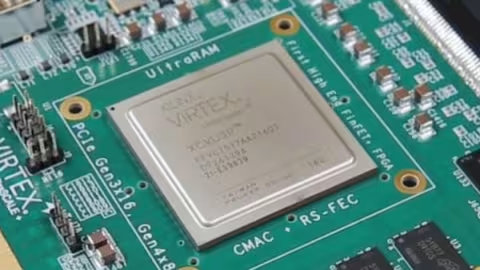
自适应和智能计算的全球领先企业赛灵思公司今天宣布推出全球最大容量的 FPGA – Virtex UltraScale+ VU19P,从而进一步扩展了旗下 16 纳米 (nm) Virtex UltraScale+ 产品系列。VU19P拥有 350 亿个晶体管,拥有有史以来单颗芯片最高逻辑密度和最大I/O 数量,可用以支持未来最先进 ASIC 和 SoC 技术的仿真与原型设计。
锁存器(latch)是电平触发的存储单元,数据存储的动作取决于输入时钟(或者使能)信号的电平值,仅当锁存器处于使能状态时,输出才会随着数据输入发生变化。简单地说,锁存器有两个输入,一个是有效信号EN,一个是输入数据信号DATA_IN,有一个输出Q,它的功能就是在EN有效的时候把DATA_IN的值传给Q,也就是锁存的过程。
本文首先介绍深度学习中的YOLOv2-Tiny目标检测算法,然后设计对应的硬件加速器,并且就加速器中各模块的处理时延进行简单建模,给出卷积模块的详细设计,最后,在Xilinx公司的Zedboard开发板上进行评估。
FPGA 是一堆晶体管,你可以把它们连接(wire up)起来做出任何你想要的电路。它就像一个纳米级面包板。使用 FPGA 就像芯片流片,但是你只需要买这一张芯片就可以搭建不一样的设计,作为交换,你需要付出一些效率上的代价
前两篇我们学习了TCP的发送,本文学习如何处理接收数据。本文使用TCP设计一个echo服务器,开发板将来自所有IP地址和端口的数据原路发送回去,功能和本系列第15篇的UDP echo服务器相同。本文实例与SDK提供的“lwip echo server”例程相比要简化许多,没有使用DHCP协议。本文主要是学习TCP的接收回调,DHCP的内容会在后面专门讲述。
VCU 模块在PL侧,一共有五个AXI接口,它们分别是两个 Encoder AXI,两个 Decoder AXI, 和一个 MCU AXI。两个 Encoder/Decoder 的 AXI 接口必须都连接到 MPSoC PS,即使只用一路编码,或者一路解码
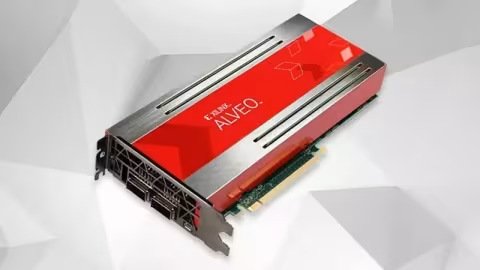
赛灵思 Alveo™ U280 数据中心加速器卡支持 PCI Express® Gen3 x 16 和 Gen4 x 8,配备 8 GB 高带宽存储器 (HBM2),旨在加速计算密集型应用,如机器学习、数据分析和视频处理存储器限制、计算密集型应用包括数据库分析和机器学习推断
Zynq器件将arm和FPGA结合,利用了两者各自的优势,arm可以实现灵活的控制,而FPGA部分可以实现算法加速,这大大扩展了zynq的应用。比如深度学习加速,图像处理等等。PL侧表示FPGA的逻辑部分,PS侧为arm端以及一些AXI接口控制部分,二者实际上通过AXI接口实现通信和互联
一个项目看上去很简单,精心设置了架构,结果越做发现冲突越多,直到整个逻辑完全混乱。本来一天可以的完成的事不知道怎么搞的一个星期还没有完成;本来只需要做一行更改,结果却涉及到N个模块;出现了一个非常小的BUG打了一个补丁
对赛灵思而言,上星期是激动人心的一个星期。业界首款半高半长、可支持 PCIe Gen 4 的自适应加速器卡Alveo U50 正式发布。长约7英寸,宽约2英寸,Alveo U50是小型封装的一大突破。该卡集成 HBM2 高带宽存储器、100Gbps 网络连接和赛灵思 UltraScale+ FPGA 架构
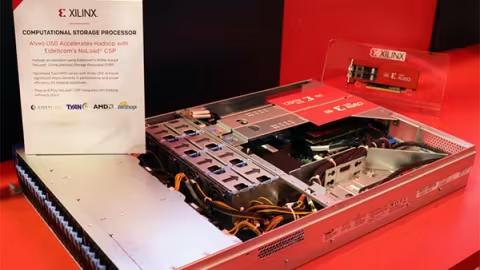
在这篇文章里你可以了解到广告推荐算法Wide and deep模型的相关知识和搭建方法,还能了解到模型优化和评估的方式。我还为你准备了将模型部署到FPGA上做硬件加速的方法,希望对你有帮助
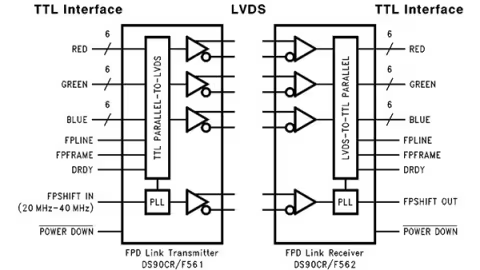
本文介绍两种LVDS数传接口:GMSL和FPD Link,这两种接口在汽车视频传输方面的应用是比较广泛的,尤其是Camera和处理器之间的链路,通过STP或者同轴电缆能使整个链路达到15m。
<strong>1、FPD Link</strong>
面向 Zynq UltraScale+ MPSoC 器件的 Xilinx® LogiCORE™ IP H.264/H.265 视频编解码器单元 (VCU) 内核能够以 60Hz 的像素对分辨率高达 4k 的视频进行同步压缩和解压缩。分辨率高出 4K 时,支持较低的帧速率。
卷积占据了CNN网络中绝大部分运算,进行乘法运算通常都是使用FPGA中的DSP,这样算力就受到了器件中DSP资源的限制。比如在zynq7000器件中,DSP资源就较少,神经网络的性能就无法得到提升。利用xilinx器件中LUT的结构特征,设计出的乘法器不但能灵活适应数据位宽,而且能最大限度降低LUT资源使用
AXI GPIO模块将PL端连接的GPIO信号通过AXI接口与PS模块连接,PS通过AXI接口的地址映射对PL端的GPIO信号进行读写等控制。与EMIO可以实现相同的功能,区别主要在于EMIO对于少数GPIO接口进行单独的控制,而AXI GPIO可以对多个GPIO接口合并成的总线进行整体读写控制。