技术
自从非易失性存储器快车(NVMe)协议问世以来,数据中心客户广泛采用了这项新技术,它为存储应用带来了更高的性能和低延迟。NVMe的功能集使该技术成为市场上增长最快的存储解决方案。国际数据公司预测,到2021年,基于NVMe的存储解决方案将产生超过50%的与主外部存储出货量相关的收入
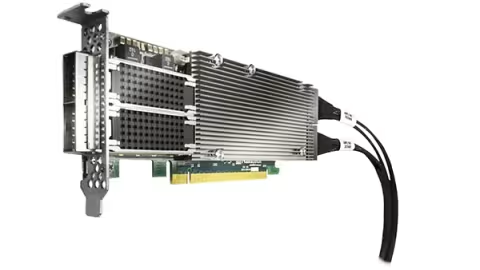
最近陆陆续续有工程师拿到了VCK190单板。 VCK190集成了Xilinx的7nm AIE,有很强的处理能力。 本文介绍怎么运行Xilinx AIE的例程,熟悉AIE开发流程。
PetaLinux 能够根据Vivado的设计,自动生成V4L2的Video Pipeline的devicetree。但是它主要为Xilinx的VCU TRD服务,测试的组合比较少。很多时候,需要根据自己的工程,修改V4L2的Video Pipeline的devicetree。
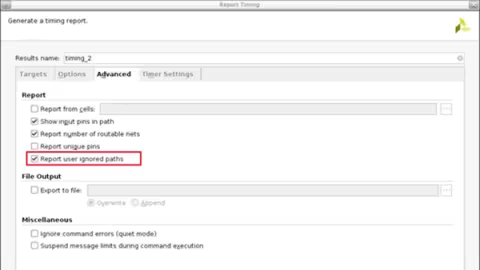
随着设计复杂度和调用IP丰富度的增加,在调试时序约束的过程中,用户常常会对除了自己设定的约束外所涉及的繁杂的时序约束感到困惑而无从下手。举个例子,我的XDC里面并没有指定set_false_path,为什么有些路径在分析时忽略了?我怎么去定位这些约束是哪里设定的?本文结合一个具体案例,阐述了如何追溯同一时钟域内partial false path的来源,希望为开发者的设计调试提供一些技巧和窍门。
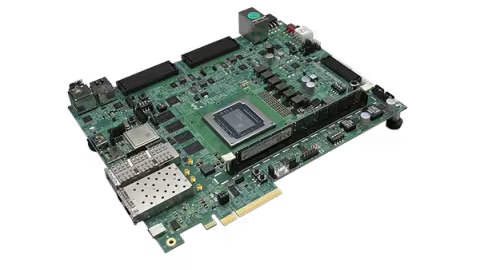
如果是VCK190 ES单板,需要在Lounge里申请"Versal Tools Early Eacess"; "Versal Tools PDI Early Eacess"的License,并在Vivado里使能ES器件。在Vivado/2020.2/scripts/init.tcl的文件里,添加“enable_beta_device xcvc*”,可以自动使能ES器件。
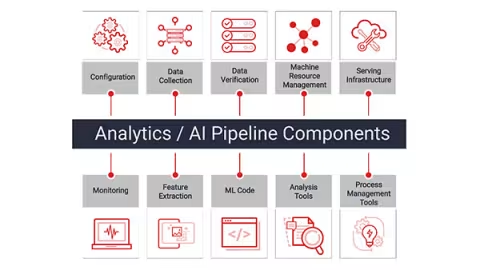
为了提升计算基础设施的性能,并紧跟数据分析与 AI 不断攀升的需求,众多企业将硬件加速视为主要的解决方案。在大多数情况下,先进的可编程硬件(主要是指 GPU 和 FPGA)是加速的主要方式。通过使用这种先进的硬件,企业正在赢得计算优势;然而,对于编程难度,他们仍然存在合理的担忧。
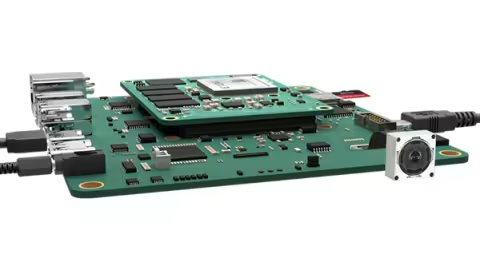
SOM (System-on-Module) 在随时可投入生产的单块印刷电路板 (PCB) 上提供嵌入式处理系统的各种核心组件,包括处理器内核、通信接口和内存模块等。有了这种模块化方法,SOM 将成为嵌入各种终端系统的理想选择,从机器人到安全摄像头,无所不包
本设计咨询涵盖如下 Versal DDRMC 设计:使用对应 LPDDR4 和 x8 或 x16 DDR4 组件接口的 DQS 字节组管脚交换所生成的设计。
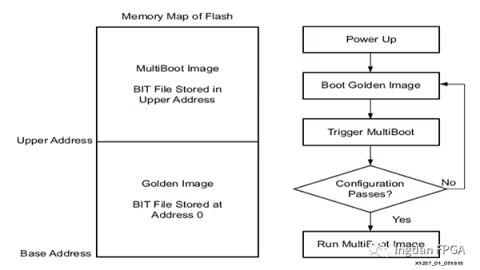
该设计咨询涵盖如下 UltraScale+ GTH/GTY 收发器问题,即 GTPOWERGOOD 在上电后可能无法断言有效。所有 UltraScale+ GTH/GTY 收发器中均包含 *_delay_powergood.v 模块。
在Vitis完成这个过程的底层,实际调用的是Vivado。Vitis会指定默认的Vivado策略来执行综合和实现的步骤。当默认的Vivado策略无法达到预期的时序要求时,我们需要在Vivado中分析时序问题的原因, 并根据时序失败的原因调整Vivado各个步骤的选项。有时我们也需要调整Vivado各个步骤的选项做不同方向的优化。
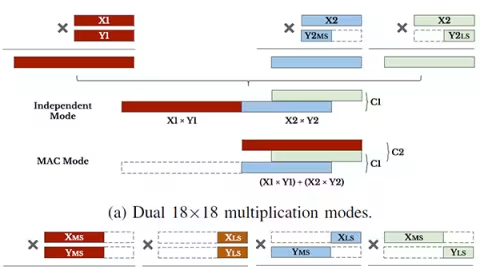
DNN加速器的设计一直在两个方面使力:通用架构和高效性能。通用性需要自顶向下的设计,首先综合各种神经网络的算子设计一套标准的指令集,然后根据硬件平台的特点,考察计算资源,存储资源以及带宽,进行硬件的模块化设计,在指令集以及硬件的特殊结构基础上,再去构建工具链。
以太网技术继续向更高、更优的性能和功能水平不断迈进。万兆以太网 (GbE) 有望满足苛刻的市场需求,提升性能并仍能兼容之前的各种变型。它可以满足高性能实时系统、云计算、零延迟传输系统和高性能嵌入式计算 (HPEC) 的苛刻需求。它也是高速处理器之间和 I/O 通信的可行性选择。
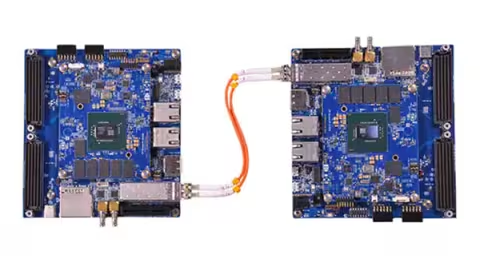
近年来,向基于NAND闪存的存储迁移和非易失性存储器快车®(NVMe™)的引入,为技术公司以不同的方式"做存储"增加了许多机会。实时数字业务的快速增长和多样性要求这种创新,以便实现新的产品和服务。本应用说明介绍了BittWare支持FPGA和MPSoC的250系列加速器产品如何用于让客户为下一代物联网和云基础设施构建高性能、可扩展的NVMe基础架构。
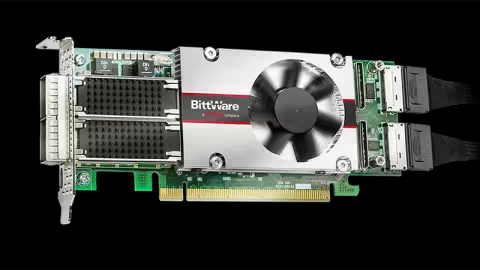
计算密集型应用是指需要大量复杂计算的任何计算机应用。像 AI 推理、大数据分析、网络和科学研究建模之类就是如今的一些比较流行的计算密集型应用。Xilinx UltraScale MPSoC 架构提供了多种高级处理器,从 32 位到 64 位,支持虚拟化,并通过“合适的任务使用合适的引擎”理念实现了真正的异构多处理能力。
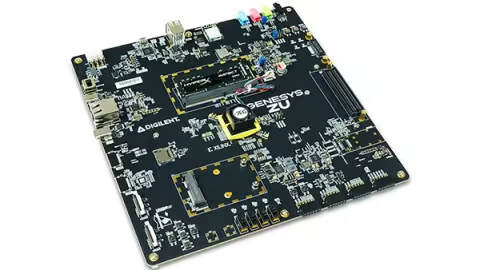
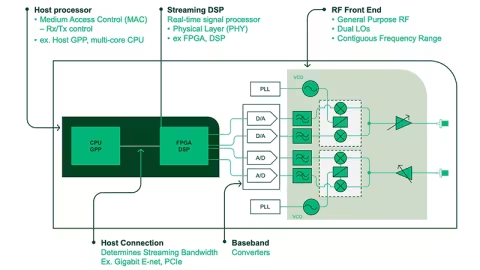
如果您计划开发一个无线应用程序,并且需要选择一款软件无线电(SDR),您可能会面临一些疑问,例如:我从何处入手?哪一款通用软件无线电外设(USRP)适合我?我应该使用哪种软件开发工具?本技术白皮书介绍了各种USRP型号之间的主要差异,可以帮助您选择合适的无线电。