技术
ECO 指的是 Engineering Change Order ,即工程变更指令。目的是为了在设计的后期,快速灵活地做小范围修改,从而尽可能的保持已经验证的功能和时序。ECO 是从 IC 设计领域继承而来,Vivado上 的 ECO 便相当于 ISE 上的 FPGA Editor。
ZU+MPSOC器件在汽车电子、工业控制、机器视觉、智能安防、智慧城市等行业中已经有着广泛的应用,三年前在做一个ZCU106开发板的TRD(Target Reference Design)向用户自研板卡移植HDMI设计时,遇到了一些问题,我翻出之前的笔记整理成文,与大家分享。
本示例工程中我们会在 TensorFlow2 下使用 Keras API 创建一个自定义 CNN 网络,在 Vitis-AI 1.3 环境下编译成 Xilinx DPU 上运行的模型文件,并在 Xilinx zynqMP 上部署运行。该示例工程应在 Vitis-AI1.3 Docker,vitis-ai-tensorflow2conda 环境中运行。
时序约束中的 set_input_delay/set_output_delay 约束一直是一个难点,无论是概念、约束值的计算,还是最终的路径分析,每一次都要费一番脑子。Vivado为方便用户创建输入输出接口的约束,整理出了一套非常实用的InputDelay/Output Delay Constraints Language Templates。
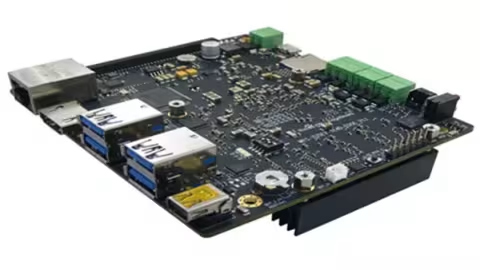
百度大脑EdgeBoard AI计算盒/计算卡系百度与米尔联合推出的一款高性能,高可靠性的AI计算盒/计算卡。该产品基于Xilinx Zynq UltraScale+ MPSoC 系列 FPGA可伸缩计算架构,可支持二次开发,支持高精度模型/多模型部署
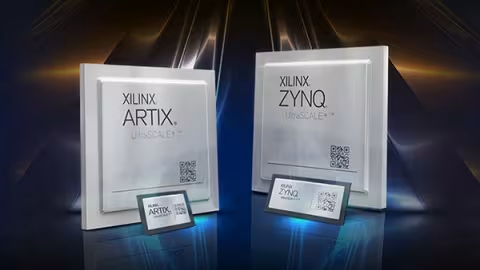
前段时间看到Xilinx发布了新的差异化ZYNQ Ultrascale+ MPSoC ZU1和Artix Ultrascale+FPGA,熊猫君趁着国家假日有点时间,随便瞎聊一下。本次发布的新产品均采用16nm的工艺,可选封装有0.5mm焊盘间距紧凑型的InFo,最小封装尺寸只有15mm*9.5mm,这种封装类型可以缩短信号互联,有利于提高信号完整性
本文介绍了一种基于VPX架构的高速宽带数据通信平台,平台的核心是机载和地面收发信机,收发信机内各功能板卡的主要控制器是FPGA。发射端对信息序列进行打包、信道编码、交织和调制;接收端对信号进行解调、解交织、解码、同步等操作。还原后的信息上传至上位机进行分析。
以太网 IP 核的 1588 功能是用来实现,在 IP 内部为TX侧发送包打上发送出去这个时间节点的时间戳,以及获得 RX 侧收回来的包在 IP 接口处的时间戳。然而10G/25G 的 IP 例子工程没有提供演示,本文主要介绍了如何使用这个 IP 的 1588功能。
因为 BD 中连线太多,所以想自定义下 interface 简化连线,定义好了一个 interface,但当准备在自定义 IP 中指定它时,发现我把一个信号的方向搞错了,应该定义成 out,但实际定义成了 in,所以想简单的改一下方向。
Alveo 加速卡除了有我们 ultrascale+系列的芯片以外,还有 TI 的 MSP432,它的作用就是监控板子的状态,比如电流电压温度等信息。主控端可以通过 FPGA,访问 MPS432,然后获取这些信息。那么怎么样简单的获得这些信息呢,为此我们准备了 CMSIP。
从 NAND 闪存启动 Zynq-7000 SoC 器件时,BootROM 中的 NAND 驱动在 NAND 参数页面 (Parameter Page) 中执行读取时不会对输入进行验证。如果从参数页面读入的备用字节包含恶意的非法值,则会导致缓冲器上溢,从而可能导致执行任意代码。
Pass是TVM中基于relay IR进行的优化,目的是去除冗余算子,进行硬件友好的算子转换,最终能够提高硬件运行效率。由tensorflow等深度学习框架生成的图机构中,含有很多可以优化的算子,比如expand_dim,len等,其实在编译阶段完全可以优化掉,从而能够减少硬件的计算,以及避免出现硬件不支持的算子。
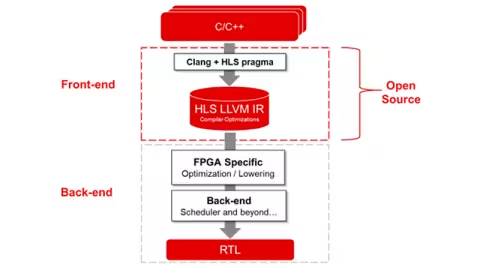
赛灵思一直致力于支持开源计划的不断飞跃,为帮助开发人员和研发社区充分发挥自适应计算的优势,我们再次做出了令人振奋的举措: 在 GitHub 上开放提供 Vitis HLS(高层次综合)前端。Vitis HLS 工具能够将 C++ 和 OpenCL™ 功能部署到器件的逻辑结构和 RAM/DSP 块上。
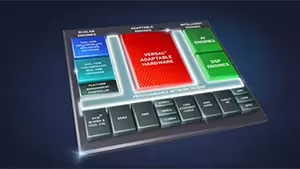
身处智能时代,科技发展日新月异,伴随数据中心、有线网络、5G 无线和汽车等愈加丰富的场景,相应的技术与功能也正经历飞速迭代,因此,单一计算架构已难以应对海量数据处理需求,赛灵思 Versal ACAP多核异构计算平台致力于帮助所有开发者保持即时的灵活应变能力。
目前ASIC的设计变得越来越大,越来越复杂,单片FPGA已不能满足原型验证要求,多片FPGA验证应运而生。RTL逻辑的分割、多片FPGA之间的互联拓扑结构、I/O分配、高速接口都对应用FPGA原型验证的芯片开发者提出了更高的要求也带来了前所未有的挑战。
本文针对上海证券交易所的行情发布系统,采用Verilog硬件描述语言,在FPGA加速卡上开发了对行情信息流的以太网,IP和UDP以及FAST协议的硬件解码,设计了支持指令集编程的微指令加速引擎。与传统的基于软件的方法相比,本文提出的专用硬件处理方案延时可降低10倍以上。
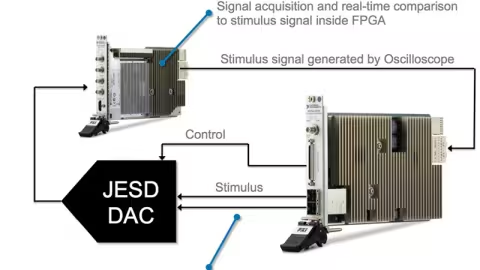
示波器的需求急速成长,同时新的研究和测试应用也需要更多、更快、更复杂的讯号。 这会需要更具智能功能的测试设备,才能准确侦测特定的讯号状况并避免空滞时间、在采集期间处理资料以缩短测试时间,或者是快速产生反馈讯号以控制待测装置 (DUT)。 过去十年来,强大 PC 软件和模块化 I/O 的紧密整合,不仅缩短了测试时间,同时也降低了整体测试成本
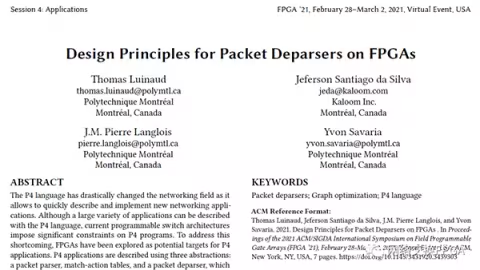
P4改变了网络格局,因为它允许表达自定义数据包处理。近年来,有几篇著作将P4程序映射到FPGA。但是,这些工作大部分都集中在实现数据包解析器或match action阶段。迄今为止,尚未有报道提出关于FPGA的通用数据包逆解析的原理。推荐一篇2021年FPGA顶会会议论文,介绍基于FPGA开源200Gbps数据包逆解析器的设计与实现。