技术
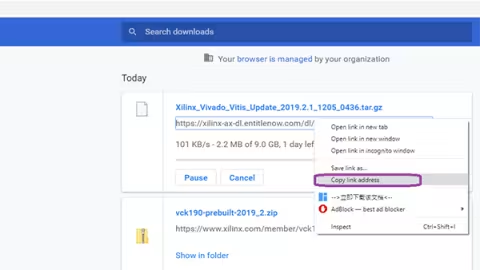
Xilinx文件基本都放在国外的服务器上。如果直接使用浏览器下载,在国内下载,速度一般比较慢。如果超过时间没有下载完,连接还会失效,导致反复下载也不能成功,成功率比较低。为了提升Xilinx文件下载速度和可靠性的办法,建议使用专门的下载工具
CLB是指可编程逻辑功能块(Configurable Logic Blocks),顾名思义就是可编程的数字逻辑电路。CLB是FPGA内的三个基本逻辑单元。CLB的实际数量和特性会依器件的不同而不同,但是每个CLB都可配置,在Xilinx公司的FPGA器件中,CLB由2个 相同的SliceL或则一个SliceL和一个SliceM构成
近来卷积神经网络(CNN)的研究十分热门。CNN发展的一个瓶颈就是它需要非常庞大的运算量,在实时性上有一定问题。而FPGA具有灵活、可配置和适合高并行度计算的优点,十分适合部署CNN。
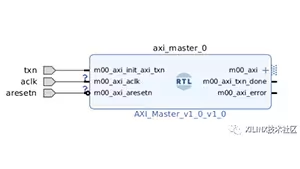
在 AXI 基础第 2 讲 一文中,曾提到赛灵思 Verification IP (AXI VIP) 可用作为 AXI 协议检查工具。在本次第4讲中,我们将来了解下如何使用它在 AXI4 (Full) 主接口中执行验证(和查找错误)
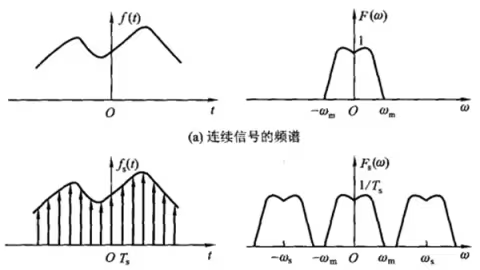
傅立叶变换是数字信号处理领域一种很重要的算法,可以将一个信号从时域变换到频域。傅立叶原理表明:任何连续测量的时序或信号,都可以表示为不同频率的正弦波信号的无限叠加。根据原信号的不同类型,傅里叶变换可以分为四种类别
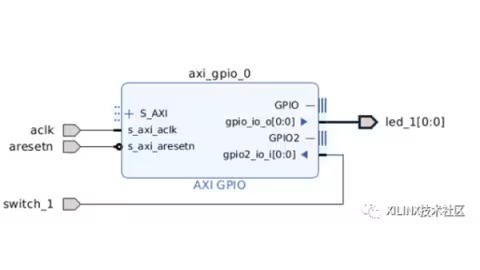
在这篇新博文中,我们来聊一聊如何将 AXI VIP 添加到 Vivado 工程中,并对 AXI4-Lite 接口进行仿真。随后,我们将在仿真波形窗口中讲解用于AXI4-Lite 传输事务的信号。
LDPC(低密度奇偶检验)码是由稀疏校验矩阵定义的线性分组码,具有能够逼近香农极限的优良特性,其描述简单,具有较大的灵活性和较低的差错误码特性,可实现并行操作,译码复杂度低,适合硬件实现,吞吐量大,极具高速译码的潜力,在码长较长的情况下,仍然可以有效译码
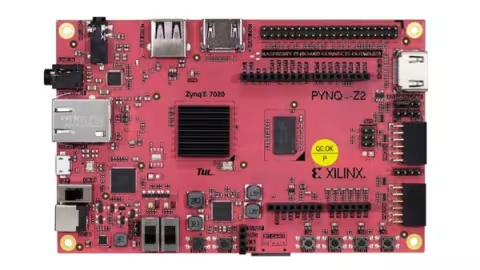
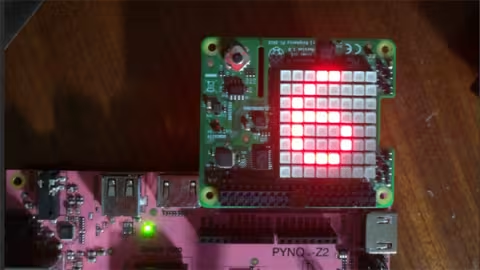
本项目介绍了Sense HAT在PYNQ上的使用。Sense HAT是是为树莓派设计的集成外设板,包含了惯性传感器、湿度温度传感器、气压传感器和一个8×8LED矩阵。这些外设通过I2C总线利用不同设备地址来访问。本项目分成三个部分介绍:LED矩阵显示字符、温度气压传感器读取和惯性传感器数据读取
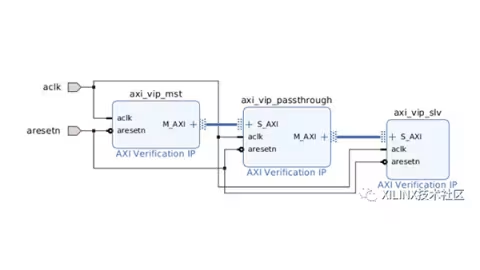
赛灵思 AXI Verification IP (AXI VIP) 是支持用户对 AXI4 和 AXI4-Lite 进行仿真的 IP。它还可作为 AXI Protocol Checker 来使用。此 IP 只是仿真 IP,将不进行综合(它将在 Pass-through 配置中被连线所替代)。
在本篇文章中,我们将介绍如何使用 Vitis 在 Alveo 板卡上开发和部署硬件加速应用。包括可用资源及文档,如何安装所需的开发工具和软件包,以及如何使用赛灵思 Github 加速用例。视频演示部分会向大家详细展示如何使用 Vitis 图形化界面和命令行流程在 Alveo U200 板卡上进行加速用例的开发和部署
针对卷积神经网络(CNN)在通用CPU以及GPU平台上推断速度慢、功耗大的问题,采用FPGA平台设计了并行化的卷积神经网络推断系统。通过运算资源重用、并行处理数据和流水线设计,并利用全连接层的稀疏性设计稀疏矩阵乘法器,大大提高运算速度,减少资源的使用
作为Python的官方第三方软件存储库PyPI,目前已将超过222,000个项目收纳囊中,PYNQ作为一款将Python开发语言与FPGA硬件设计完美衔接的产品,自然也是迫不及待地入住PyPI。点开PyPI主页面搜索PYNQ,可以看到已经有边缘PYNQ, Alveo板卡
神经网络中涉及到大量的张量运算,比如卷积,矩阵乘法,向量点乘,求和等。神经网络加速器就是针对张量运算来设计的。一个神经网络加速器通常都包含一个张量计算阵列,以及数据收发控制,共同来完成诸如矩阵乘法,卷积等计算任务
Vivado设计有工程和非工程两种模式:工程模式是使用Vivado Design Suite自动管理设计源文件、设计配置和结果,使用图形化Vivado集成设计环境(IDE)交互式处理设计。工程模式下,既可以通过图像界面下操作(GUI操作,鼠标操作),也可以通过运行Tcl脚本的方式在Vivado Tcl shell 中运行。
用机器视觉技术取代人工,可以提供生产效率和产品质量,因此机器视觉技术广泛应用于工业检测(机械零部件的尺寸和位置测量)、机器人视觉、人脸识别、车牌识别、自动光学检查、无人驾驶汽车、追踪定位等领域
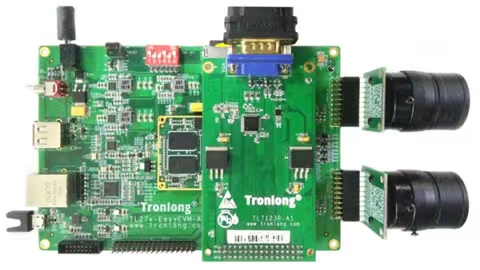
ZYNQ中包含了两个部分,双核的arm和FPGA。根据XILINX提供的手册,arm模块被称为PS,而FPGA模块被称为PL。ZYNQ内部包含PS和PL两部分,ZYNQ开发有一下四种方式
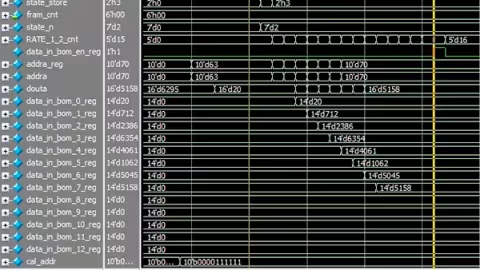
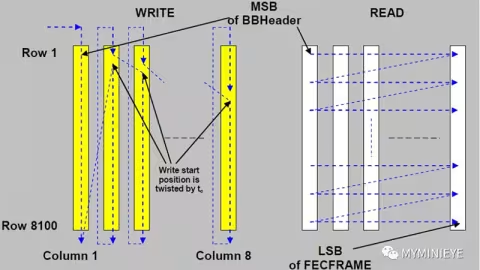
当调制方式为16-AQM,64-QAM和256-QAM时需要做位交织,交织的目的是将突发的错误分散开来,把一个较长的突发差错离散成随机差错,再用随机差错的编码(FEC)等信道编码技术消除随机差错,提高通信的可靠性。交织的越深,抗突发错误的能力也越强
最近有朋友问,公众号为什么起名叫网络交换FPGA?今天这篇文章就来回答一下。我们将从网络交换的历史讲起,也正如机器学习也赶上了ASIC工艺发展才引起革命性的变化一样。技术发展的历程中,总有那些看似不相关的技术结合起来,结果导致翻天覆地的变化