跳转到主要内容
FPGA开发圈
聚焦 FPGA 设计、嵌入式开发与可编程技术
Main-menu-for-FPGA
快讯
技术
活动
博客
登录
注册
AAI 2026:AMD推出适用于前沿AI的 AMD Helios机架级解决方案
全新AI基础设施融合了领先的计算能力、网络和开放软件,为大规模AI提供机架级性能。
AMD Vitis™ AI 6.2 版现已推出!
AMD Vitis™ AI 6.2 版现已推出。此版本首次面向公众开放第二代 AMD Versal™ AI 引擎系列的多项重要功能
FPGA小课堂-使用DDR4控制器实现多通道数据读写(9)
本文重点讲如何利用读写DDR4的接口来实现对DDR4的读写控制。
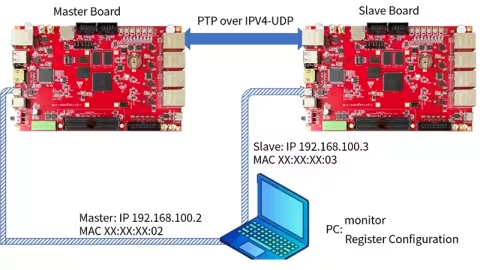
纳秒级时序守护电网安全!安路 DR1 FPSoC 软硬协同实现 ±130ns PTP 时钟同步
基于DR1 FPSoC®器件构建的高精度时钟同步方案实现对IEEE 1588v2(IEEE 1588-2008)精密时间协议的高精度支持。
这台机器人足够安全——但它足够可信吗?
当大多数团队开始评估人形机器人的安全性时,他们打开的是一份熟悉的参考手册:传统IT安全框架、工业机器人防护标准,或者消费级IoT的通行做法
GTY – TX Gearbox的工作机制详解
以 64B/66B、4-byte 逻辑接口(每拍输入 2-bit Header + 32-bit TXDATA)为例,TX Gearbox 的输出过程如下
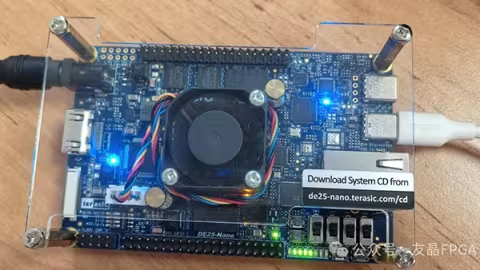
Agilex 5 SoC 的两种启动模式的开发演示(二)(HPS Boot First )
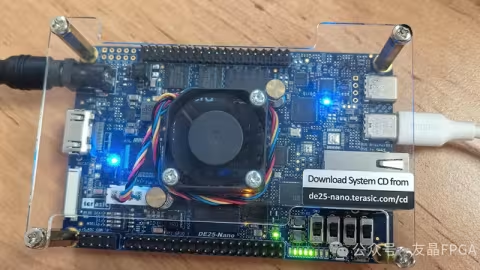
本文将首先介绍这两种启动模式的工作方式,然后在 DE25‑Nano 开发板上完整演示其开发与验证流程。
FPGA小课堂-使用DDR4控制器实现多通道数据读写(8)
在之前的章节已经详细介绍了DDR4的AXI协议,并实现了对DDR4简单的读写操作。这一章节来建立单通道的256位数据的读写,并放出工程框架,说明整体设计思路
莱迪思半导体完成收购 AMI
莱迪思半导体今日宣布完成对 AMI 的收购。本次收购于2026年5月4日首次公布,双方合作将打造业内业界领先的安全管理与控制平台
雷达架构正在重构:RFSoC如何开启下一代数字敏捷雷达时代?
Andromeda XRU50 RFSoC模块将高速ADC、DAC、FPGA处理能力以及射频采样能力集成到一个紧凑型SoM平台中,让雷达设计者能够以更简单的硬件架构,实现更高性能、更灵活的数字化雷达系统。
Agilex 5 SoC 的两种启动模式的开发演示(一)(FPGA Configuration First)
本文将首先介绍这两种启动模式的工作方式,然后在 DE25‑Nano 开发板上完整演示其开发与验证流程。
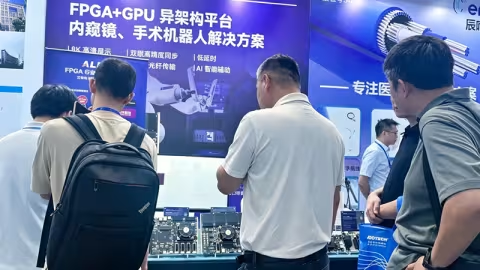
ALINX 精彩亮相 CCME 2026 第十届内镜大会,FPGA+GPU 异构方案引领医疗影像新未来
ALINX Z19-M 融合 AMD Zynq UltraScale+ 与 NVIDIA Jetson Orin,支持 8K 视频实时采集,端到端延迟控制在 50ms 以内,左右眼视频数据同步精度达到 1 行
Vitis AI 6.2 入门:在 VEK385 上跑通第一个模型
本文是 Vitis AI 6.2 系列的第一篇。目标是在不编写代码、不进行模型量化与编译的前提下,使用发布包中提供的预编译模型,在 VEK385 开发板上完成端到端推理(图像分类与目标检测)
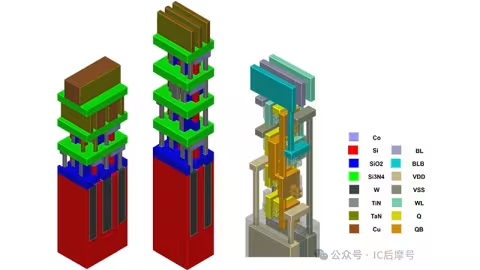
紧凑3D SRAM 器件级堆叠使能关键缩放
今天我们来看一种在1纳米工艺节点下目前最紧凑的6T SRAM研究,将CFET堆叠扩展为多层构型,凸显3D器件级堆叠在尺寸缩放的使能潜力。
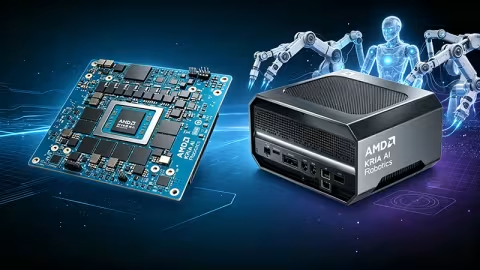
AMD放出“大招”:机器人终于迎来自己的AI大脑?
未来机器人拼的不只是机械臂,而是谁拥有更强的“大脑”。AMD正在用Kria AI开启一场新的机器人计算战争。
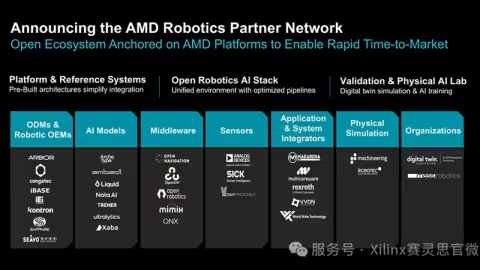
AAI 2026:全新 AMD 开放机器人合作伙伴网络助力物理 AI 开发
不断扩大的开放生态系统,汇聚软件开发商、AI 模型提供商、机器人技术企业、硬件合作伙伴与行业组织,加速基于 AMD 平台的机器人迈向量产。
AAI 2026:AMD 面向物理 AI 推出开放式交钥匙集成平台
AMD Kria AI 解决方案将机器人能力从“身体”扩展至“大脑”,并结合 Kria AI 系统模块、机器人开发者平台及开放软件生态系统,加速物理 AI 发展。
FPGA小课堂-使用DDR4控制器实现多通道数据读写(7)
在上一节中,我们使用DDR4的AXI接口做了一个简单的读写测试,这一节我们使用数据掩码(wstrb)来控制写入数据的有效字节。
FPGA开发利器IC Coder 2.0 全新上线,启动内测!
本次版本面向 FPGA 真实研发场景,对自研 FPGA 专用模型、Agent 执行平台、企业本地知识库、板卡适配与芯片适配能力进行了系统升级。
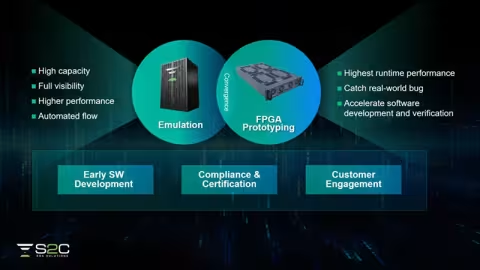
面向超大规模SoC的硬件辅助验证:技术演进与左移策略实践
硬件辅助验证 (HAV) 已不仅仅是验证流程中的加速器,更是现代超大规模SoC设计不可或缺的系统。它通过融合硬件仿真的“高精度调试”与FPGA原型的“高性能运行”
分页
« 首页
首页
‹ 上一个
前一页
…
7
8
9
10
11
12
13
14
15
…
下一个 ›
下一页
末页 »
末页
订阅