数字电路设计中一般包括3个大的阶段:源代码输入、综合和实现,而电路仿真的切入点也基本与这些阶段相吻合,根据适用的设计阶段的不同仿真可以分为RTL行为级仿真、综合后门级功能仿真和时序仿真。这种仿真轮廓的模型不仅适合FPGA/CPLD设计,同样适合IC设计
SystemVerilog 接口的开发旨在让设计中层级之间的连接变得更加轻松容易。 您可以把这类接口看作是多个模块共有的引脚集合。与必须在每个模块上定义多个引脚不同的是,您只需在接口中对引脚定义一次,之后只需在模块上定义接口即可。 如果稍后接口中涉及的信号被更改,则仅需更改接口即可
如果符合一些简单的设计原则,采用最新的Xilinx7系列FPGA架构上实现无线通信。Xilinx公司已经创建了典型无线数据路径的设计范例,表明中速级(-2)器件上使用的几乎100%的 slice资源都支持500 MHz以上的时钟频率。如何真正时序高速设计,需要注意一下几点
在做FPGA的开发过程中经常会使用到移位寄存器,一般我们使用移位寄存器的目的都是为了将某个信号进行打拍,使得时序符合我们的需求。最常见的一种打拍方法就是在process过程语句中对信号进行移位。但是这里我给大家介绍一下SRL6E
人工智能是推动数字化转型与创新的原动力,将成为引领第四次工业革命的核心驱动力,而以计算力为核心的人工智能已从探索走向实践。3月28日,IDC和浪潮联合研究发布的《2018-2019中国人工智能计算力发展评估报告》强调了这一观点。该年度报告旨在评估中国人工智能发展的现状,探索中国企业的破局之道。
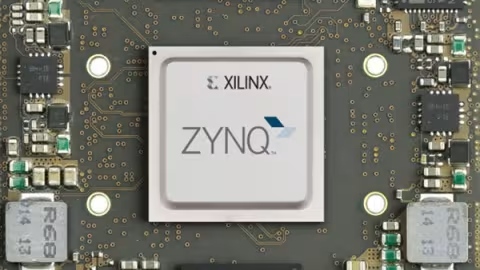
本系列将讲述如何使用Vivado完成基于Zynq平台的嵌入式系统设计。一个完整的嵌入式系统设计要考虑硬件、软件、FPGA设计三个部分。Xilinx为了尽量简化设计流程,提供如下两个主要设计工具
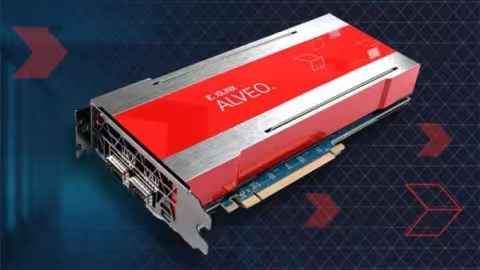
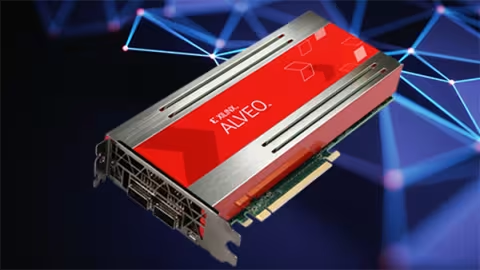
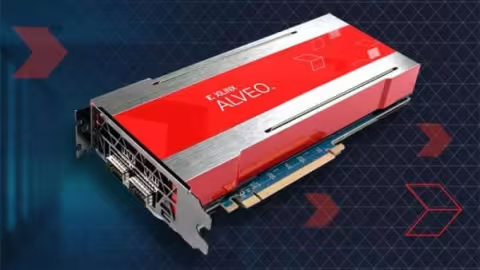
Alveo 数据中心加速卡在硬件中配置了两个 QSFP 端口。这些如何用于在 U200/U250 卡上启用以太网子系统 IP?
利用卷积神经网络(Convolutional Neural Network, CNN) 等深层神经网络的解决方案,可以逐渐取代基于算法说明的传统图像处理工作。尽管图像预处理、后期处理和信号处理仍采用现有方法进行,但在图像分类应用中(缺陷、对象以及特征分类),深度学习变得愈加重要
背景:zynqNet运用HLS来实现相应的IPcore。相关HLS过程的信息会打印到console之中。目的:读懂HLS对IPcore代码的HLS过程,具体硬件如何实现。将报告信息存下来用于参考。
据外媒报道,人工智能(AI)正在各个行业普及,由于每天都有新的发展成为头条新闻,很难从炒作中挑选出最重要的进展。AI接下来会如何进化?知名市场研究机构CB Insights的分析师调查了各个行业,以确定2019年需要重点关注的25个AI大趋势,从下一代假肢到作物监测等。
边缘计算是5G网络的核心特征,也是结合5G智能物联时代的核心应用特征,针对智能物联场景的特异性,边缘计算对算力需求将呈现定制化个性化的特征,驱动算力产业领域FPGA产业迎来历史性的机会,这也是我们继边缘计算小基站和边缘计算物联应用两篇系列报告之后的最新核心观点。
浪潮宣布已在其NF5280M5、NF5468M5等服务器上完成对赛灵思Alveo U200、Alveo U250 FPGA加速卡的全部认证测试,搭载U200和U250的两款浪潮服务器已可公开购买。NF5280M5、NF5468M5服务器为浪潮的明星产品,分别为AI应用优化、AI云设计,能够针对用户需求进行灵活适配
112G PAM4 是业界通向更高带宽的下一步。该演示主要介绍 Xilinx 针对新一代系统提供 112G 的远景。
<iframe src='//players.brightcove.net/17209957001/SywTPUVC_default/index.html?videoId=6015799157001' allowfullscreen frameborder=0 width="600" height="400"></iframe>
各方竞争加剧,产品周期缩短,哪些底层技术将最快获益?2019年4月11日,赛灵思 AI 市场发展总监刘竞秀将出席第八届EEVIA年度中国ICT媒体论坛暨2019产业和技术展望研讨会,通过“赛灵思人工智能平台-人工智能边缘计算加速引擎”的主题演讲,分享人工智能时代,灵活应变的赛灵思平台如何与人工智能发展的速度完美匹配,如何从各种传统的计算方案中脱颖而出,成为行业发展的大势所趋
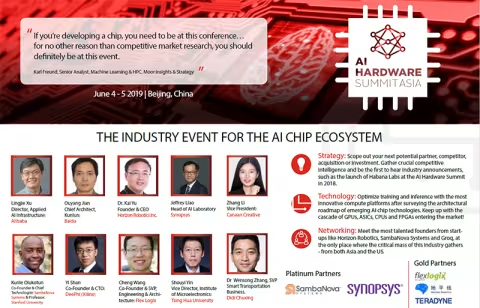
AI 硬件亚洲峰会(AI Hardware Asia Summit) 将要拉开帷幕。这是该系列全球活动的第二个专场,会议主题为 AI 加速器技术以及用于处理深度学习、神经网络和计算机视觉的芯片和系统设计与应用。赛灵思人工智能高级总监单羿将发表题为 “基于FPGA的AI平台、技术、应用和生态系统” 的主题演讲
时钟信号是FPGA时序逻辑设计中必不可少的条件,一般情况下在FPGA始终资源充裕的情况下通常采用FPGA内部自带的内核生成时钟信号,例如DLL/MMC,但是一旦出现资源不够的情况,就只能另寻他法了
与 O-RAN 联盟成员 AT&T、Anokiwave、Ball Aerospace 和 Keysight 合作,实现了 O-RU 概念验证演示。
<iframe src='//players.brightcove.net/17209957001/SywTPUVC_default/index.html?videoId=6013620831001' allowfullscreen frameborder=0 width="600" height="400"></iframe>
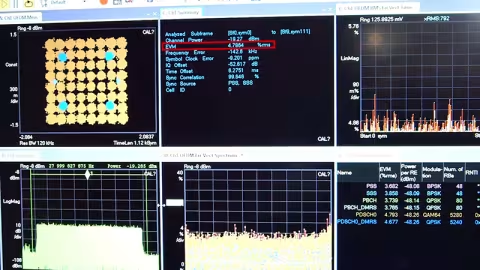
本课程向新老设计人员介绍了 UltraScale™ 器件架构的最新内容,包括介绍全新CLB资源、时钟管理资源(MMCM 和 PLL)、全局和区域时钟资源、存储和DSP资源、源同步资源及IO接口模块特性。 同时,也阐述了如何将原有设计移植到最新UltraScale器件架构上