技术
锁存器(latch)是电平触发的存储单元,数据存储的动作取决于输入时钟(或者使能)信号的电平值,仅当锁存器处于使能状态时,输出才会随着数据输入发生变化。简单地说,锁存器有两个输入,一个是有效信号EN,一个是输入数据信号DATA_IN,有一个输出Q,它的功能就是在EN有效的时候把DATA_IN的值传给Q,也就是锁存的过程。
本文首先介绍深度学习中的YOLOv2-Tiny目标检测算法,然后设计对应的硬件加速器,并且就加速器中各模块的处理时延进行简单建模,给出卷积模块的详细设计,最后,在Xilinx公司的Zedboard开发板上进行评估。
FPGA 是一堆晶体管,你可以把它们连接(wire up)起来做出任何你想要的电路。它就像一个纳米级面包板。使用 FPGA 就像芯片流片,但是你只需要买这一张芯片就可以搭建不一样的设计,作为交换,你需要付出一些效率上的代价
VCU 模块在PL侧,一共有五个AXI接口,它们分别是两个 Encoder AXI,两个 Decoder AXI, 和一个 MCU AXI。两个 Encoder/Decoder 的 AXI 接口必须都连接到 MPSoC PS,即使只用一路编码,或者一路解码
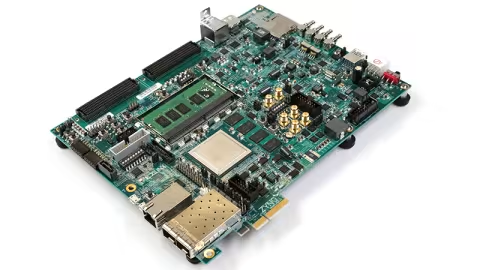
Zynq器件将arm和FPGA结合,利用了两者各自的优势,arm可以实现灵活的控制,而FPGA部分可以实现算法加速,这大大扩展了zynq的应用。比如深度学习加速,图像处理等等。PL侧表示FPGA的逻辑部分,PS侧为arm端以及一些AXI接口控制部分,二者实际上通过AXI接口实现通信和互联
一个项目看上去很简单,精心设置了架构,结果越做发现冲突越多,直到整个逻辑完全混乱。本来一天可以的完成的事不知道怎么搞的一个星期还没有完成;本来只需要做一行更改,结果却涉及到N个模块;出现了一个非常小的BUG打了一个补丁
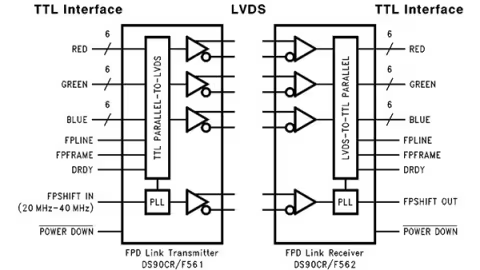
本文介绍两种LVDS数传接口:GMSL和FPD Link,这两种接口在汽车视频传输方面的应用是比较广泛的,尤其是Camera和处理器之间的链路,通过STP或者同轴电缆能使整个链路达到15m。
<strong>1、FPD Link</strong>
卷积占据了CNN网络中绝大部分运算,进行乘法运算通常都是使用FPGA中的DSP,这样算力就受到了器件中DSP资源的限制。比如在zynq7000器件中,DSP资源就较少,神经网络的性能就无法得到提升。利用xilinx器件中LUT的结构特征,设计出的乘法器不但能灵活适应数据位宽,而且能最大限度降低LUT资源使用
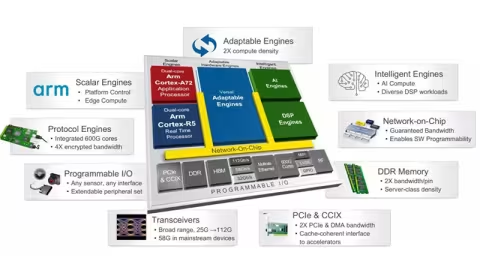
ACAP是Xilinx推出的一种革命性异构计算架构,计划在今年10月份推出。它将标量计算,可编程逻辑还有矢量计算结合在一起,充分利用各自的优势,不仅仅增强了针对各种机器学习算法的适用性,也提高了计算密度和存储带宽。其中AI engine和NoC是新颖的设计,FPGA和CPU的结合早在zynq系列中已经应用
以交换机设计为例。在交换机设计前期,转发表项是固化在交换机内部的(给FPGA片内BRAM初始值),但是在测试过程中,往往需要对表项进行修改,如果直接修改BRAM的coe文件,则需要重新综合、实现、生成bit文件,其中,综合与实现耗时十分严重,设计规模越大,消耗的时间越长,而生成bit文件消耗的时间则相对固定
本文转载自CSDN李锐博恩Reborn某校招题目,仅仅给出下面电路图,要求画出Q1,Q2以及Q3的波形,并描述电路功能。可以看出,这个电路很简单,或许你会纠结于初值是什么,可是仔细想想,该电路其实和初值没有关系
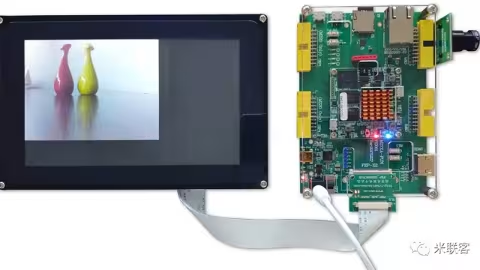
Xilinx新一代 SOC,Zynq UltraScale+ MPSOC系列性能强悍无比,相比ZYNQ 7000系列每瓦性能提升5倍,作为一 名电子发烧友,都想体验一把这高性能的MPSOC开发板。现在用米尔MPSOC开发板来一个hello world。
下载modelsim,这里用的是modelsim10.4版本。完成下载和安装,在安装文件夹中可以看到uvm-1.1d,这是我们使用的uvm版本。在uvm-1.1d/win64下有uvm_dpi.dll文件,这是已经编译过的uvm库。
在实际开发中,我们会经常使用到LCD屏,LCD屏的种类有很多种,对应的使用方法也有所不同,但是,在ZYNQ 图像传输开发中,思路大体类似,下面介绍在ZYNQ中,使用LCD显示OV5640图像方法
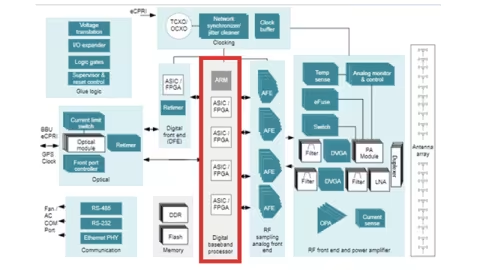
5G是目前通信设备领域的市场趋势, Massive MIMO指的是64T64R应用中常用的多输入和多输出, 更多的发送器和接收器通道需要更多的数字处理器(FPGA / ASIC)来执行数据传输,而典型的64T64R MIMO应用中通常需要4-5个数字处理器。 每个FPGA都需要自己的电源上电/下电的时序,以便FPGA能够正常工作
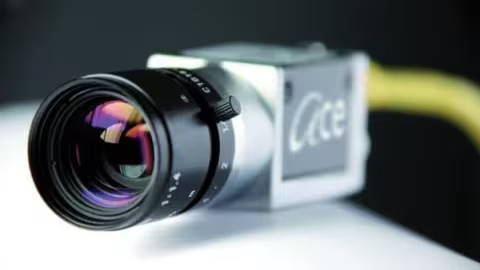
工业相机有多种分类方法,比较常见有:按感光芯片的类型分CCD(电荷耦合器件)和CMOS(互补金属氧化物半导体),根据输出色彩分为黑白和彩色,按像元的排列方式可分为线阵和面阵,按成像维度可为二维(2D)和三维(3D)等。本文将针对这四类分法,研究和讨论工业相机的基本原理及技术发展
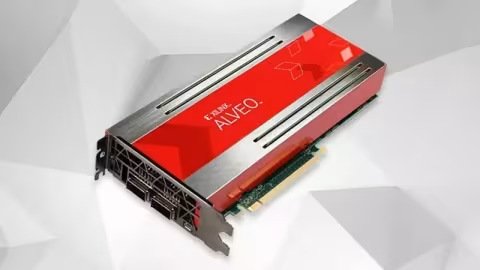
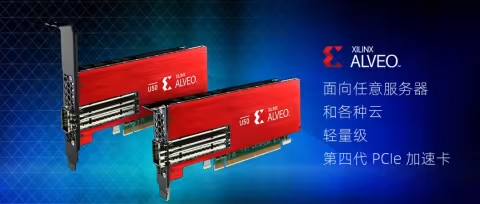
赛灵思 Alveo™ U50 数据中心加速器卡为金融计算、机器学习、计算存储以及数据搜索和分析领域的工作负载提供优化加速功能。U50 基于赛灵思 UltraScale+™ 架构,采用高效的 75 瓦封装,外形小巧,U50 包括 带宽为 460GB/s 的 HBM2,100GbE 网络和 PCI Express 4.0,专为部署在任意服务器上而打造
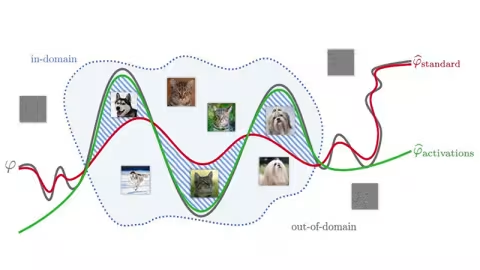
这篇文章介绍一种不同于针对压缩单个权重的方法:多个权重数据组合为向量,将向量视为一个整体,映射到其他向量空间,完成压缩。作者在resnet-50上做了实验,将100MB权重压缩到了5MB(实现了20倍压缩比例),同时在imageNet上测试的top-1精度保持的很好(76.1%)